3 Embeddings und Vektordatenbanken
Im vorherigen Kapitel haben wir aus echten Dokumenten strukturierte Chunks erzeugt. Unser kleines RAG-System kann Markdown-Dokumente einlesen, Überschriftenstrukturen berücksichtigen und relevante Textabschnitte mithilfe von Embeddings finden.
Technisch hat unser bisheriger Ansatz jedoch ein grundlegendes Problem: Bei jedem Programmstart berechnen wir sämtliche Dokument-Embeddings erneut.
Für zwei kleine Dokumente fällt das kaum ins Gewicht. Bei Hunderten, Tausenden oder Millionen von Chunks wäre dieses Vorgehen jedoch unnötig teuer und zeitaufwendig.
Dabei haben sich die meisten Dokumente zwischen zwei Benutzeranfragen überhaupt nicht verändert. Warum sollten wir ihre Embeddings also immer wieder neu berechnen?
Die Lösung besteht darin, zwei Vorgänge voneinander zu trennen:
- Ingestion: Dokumente werden eingelesen, aufbereitet, in Chunks zerlegt und eingebettet. Die Ergebnisse werden dauerhaft gespeichert.
- Query-Verarbeitung: Für eine neue Benutzerfrage erzeugen wir ein Query-Embedding und suchen damit in den bereits gespeicherten Dokument-Embeddings.
Diese Trennung ist ein grundlegender Architekturbaustein produktiver RAG-Systeme.
In diesem Kapitel setzen wir sie mit Chroma, einer Vektordatenbank, praktisch um. Wir lernen, wie sich Embeddings zusammen mit Dokumenttexten und Metadaten speichern und effizient durchsuchen lassen.
Dabei beschäftigen wir uns auch mit Fragen, die über die reine Speicherung hinausgehen: Wie unterscheiden sich Similarity und Distance? Wie begrenzen Metadaten den Suchraum? Und warum bedeutet ein semantisch ähnlicher Treffer nicht automatisch, dass die enthaltenen Informationen fachlich gültig sind?
Am Ende des Kapitels sind Dokumentverarbeitung und Benutzeranfragen erstmals voneinander getrennt. Die Dokument-Embeddings liegen dauerhaft in Chroma und können bei jeder neuen Anfrage wiederverwendet werden.
So arbeiten wir mit dem Python-Labor
Wie in Kapitel 2 verwenden wir das begleitende Python-Projekt rag-python-lab und den bereits eingeführten Teralune-Corpus.
Die Experimente bestehen aus kleinen, eigenständig ausführbaren Python-Programmen. Im Buch betrachten wir ausgewählte Codeausschnitte und die beobachteten Ergebnisse. Die vollständigen Programme können wir jederzeit lokal ausführen.
Öffne dazu ein Terminal im Projektverzeichnis von rag-python-lab.
Falls die Python-Umgebung noch nicht eingerichtet ist, installiere zunächst die im Projekt definierten Abhängigkeiten:
Alle neun Experimente dieses Kapitels liegen im Verzeichnis 03_embeddings_and_vector_database/.
Wir starten sie wie gewohnt aus dem Projektverzeichnis. Beispielsweise:
Die neun Experimente bauen aufeinander auf:
| Skript | Thema | Abschnitt |
|---|---|---|
01_embedding_cost.py |
Embedding-Aufwand abschätzen | 3.1 |
02_chroma_basics.py |
Chroma und persistente Speicherung | 3.2–3.4 |
03_index_chunks.py |
Zwei Dokumente indexieren | 3.5 |
04_vector_search.py |
Gespeicherte Chunks durchsuchen | 3.6 |
05_metadata_filtering.py |
Nach Dokument-ID filtern | 3.7 |
06_index_corpus.py |
Größeren Teralune-Corpus indexieren | 3.8–3.9 |
07_vector_search_corpus.py |
Suche über 115 Chunks | 3.10 |
08_version_filtering.py |
Version und Status filtern | 3.11 |
09_rag_with_chroma.py |
RAG-Antwort mit Chroma erzeugen | 3.12 |
Nicht jeder Abschnitt benötigt ein eigenes Experiment. In Abschnitt 3.3 vergleichen wir beispielsweise verschiedene Vector Stores zunächst konzeptionell.
Einige Programme erzeugen Embeddings oder Antworten über die OpenAI API. Dafür muss der API-Schlüssel wie in den bisherigen Experimenten in der lokalen Umgebung verfügbar sein. Diese Aufrufe können Kosten verursachen.
Andere Programme verwenden bereits gespeicherte Embeddings oder zählen lediglich Token und benötigen deshalb keinen erneuten Embedding-Aufruf.
Wichtig ist die Reihenfolge der Experimente.
Wir beginnen mit kleinen Beispieldaten und lernen die grundlegenden Funktionen von Chroma kennen.
Anschließend indexieren wir die beiden Dokumente aus Kapitel 2. Daraus entstehen acht Chunks, die wir in der Collection teralune_chunks speichern.
In Abschnitt 3.9 erweitern wir unser Experiment auf 36 Markdown-Dokumente aus dem Teralune-Corpus. Die daraus entstehenden 115 Chunks speichern wir in einer zweiten Collection namens teralune_corpus.
Diese größere Collection verwenden wir anschließend für die Such- und RAG-Experimente in Abschnitt 3.10 bis Abschnitt 3.12.
Der Ablauf unseres Python-Labors lässt sich in drei Phasen unterteilen:
flowchart LR
    subgraph S["1. Vorbereitung"]
        direction TB
        A["rag-python-lab"]
        B["Abhängigkeiten<br/>mit uv installieren"]
        C["Chroma-Grundlagen<br/>kennenlernen"]
        A --> B --> C
    end

    subgraph I["2. Indexierung"]
        direction TB
        D["teralune_chunks<br/>2 Dokumente · 8 Chunks"]
        E["teralune_corpus<br/>36 Dokumente · 115 Chunks"]
        D --> E
    end

    subgraph R["3. Retrieval und RAG"]
        direction TB
        F["Vektorsuche"]
        G["Metadatenfilter"]
        H["RAG-Antwort"]
        F --> G --> H
    end

    C --> D
    E --> F

    classDef input fill:#DBEAFE,stroke:#2563EB,color:#1E40AF
    classDef processing fill:#DCFCE7,stroke:#16A34A,color:#166534
    classDef retrieval fill:#FFEDD5,stroke:#EA580C,color:#9A3412
    classDef infrastructure fill:#F3F4F6,stroke:#6B7280,color:#374151

    class A input
    class B infrastructure
    class C,D,E processing
    class F,G retrieval
    class H input

    style S fill:#F8FAFC,stroke:#94A3B8,color:#334155
    style I fill:#F0FDF4,stroke:#86EFAC,color:#166534
    style R fill:#FFF7ED,stroke:#FDBA74,color:#9A3412
Die beiden Collections erfüllen unterschiedliche Aufgaben.
Mit teralune_chunks untersuchen wir zunächst an nur acht Chunks, wie persistente Speicherung und Vektorsuche funktionieren. Die kleine Datenmenge macht es leicht, die einzelnen Schritte nachzuvollziehen.
teralune_corpus bildet anschließend die Grundlage für realistischere Retrieval-Experimente mit unterschiedlichen Dokumentversionen, Statuswerten und Zugriffsklassen.
Diese Collection werden wir auch in Kapitel 4 weiterverwenden, wenn wir verschiedene Retrieval-Strategien untersuchen und miteinander vergleichen.
3.1 Warum wir Embeddings nicht ständig neu berechnen
In Kapitel 2 haben wir zwei Teralune-Dokumente verarbeitet: D002 mit der Dokumentation zu OAuth und API Keys sowie D022 mit Informationen zu Pagination und Cursors.
Unser strukturorientierter Chunker erzeugt daraus acht Chunks. Für jeden dieser Chunks berechnen wir ein Embedding, damit wir später semantisch ähnliche Textabschnitte finden können.
Bisher geschieht das bei jedem Programmstart erneut. Selbst wenn sich die Dokumente nicht verändert haben, erzeugen wir dieselben acht Embeddings noch einmal.
Bei zwei Dokumenten ist das kaum ein Problem. Bei einem größeren Wissensbestand wird daraus jedoch ein unnötiger Aufwand.
Experiment 3.01: Wie viele Token betten wir erneut ein?
Bevor wir eine Vektordatenbank einsetzen, untersuchen wir zunächst, wie viele Token unser bisheriger Ansatz bei jedem Programmstart erneut verarbeiten würde.
Das Experiment verwendet dieselben beiden Dokumente wie in Kapitel 2. Es lädt die Markdown-Dateien, erzeugt strukturorientierte Chunks und zählt anschließend die Token, die für deren Embeddings benötigt würden.
Wichtig: Das Skript erzeugt selbst keine Embeddings. Es zählt lediglich die Token und verursacht deshalb keine Kosten für Embedding-Aufrufe.
Starte das Experiment aus dem Projektverzeichnis:
Die Ausgabe unseres Laborlaufs lautet:
Documents: 2
Chunks: 8
Tokens to embed: 1137

Chunks:
D002:1 | tokens= 137 | OAuth and API Keys > Machine credentials
D002:2 | tokens= 154 | OAuth and API Keys > Claims and scopes
D002:3 | tokens= 120 | OAuth and API Keys > Rotation without interruption
D022:1 | tokens= 110 | Pagination and cursors > Cursor traversal
D022:2 | tokens= 109 | Pagination and cursors > Cursor traversal > Cursor validity
D022:3 | tokens= 122 | Pagination and cursors > Cursor traversal > Ordering and consistency
D022:4 | tokens= 196 | Pagination and cursors > Recover an interrupted traversal
D022:5 | tokens= 189 | Pagination and cursors > Query ownership and child pages

If the program starts again, all these chunks would be embedded again with our current approach.
Unsere acht Chunks enthalten zusammen 1137 Token, die wir für die Erstellung der Dokument-Embeddings verarbeiten würden.
Diese Zahl ist für sich genommen nicht besonders groß. Entscheidend ist jedoch, dass wir denselben Aufwand bei jedem Programmstart erneut verursachen.
Die Inhalte von D002 und D022 haben sich nicht verändert. Trotzdem würden wir ihre Embeddings immer wieder berechnen.
Bei 100.000 Chunks müssten wir entsprechend 100.000 Texte erneut an das Embedding-Modell senden, obwohl die meisten davon möglicherweise seit Wochen unverändert sind.
Das kostet Zeit und verursacht bei kostenpflichtigen Embedding-Modellen unnötige API-Kosten.
Dokument-Embeddings müssen nicht bei jeder Anfrage entstehen
Ein Embedding ist das Ergebnis einer Berechnung. Für einen bestimmten Text und ein festgelegtes Embedding-Modell können wir die erzeugte Vektorrepräsentation speichern und später wiederverwenden.
Daraus ergibt sich eine einfache Regel:
Dokument-Embeddings berechnen wir bei der Aufnahme oder Änderung eines Dokuments, nicht bei jeder Benutzerfrage.
Bei einer neuen Benutzerfrage benötigen wir dagegen tatsächlich ein neues Embedding. Schließlich müssen wir die Frage in denselben Vektorraum übertragen, in dem sich unsere Dokument-Embeddings befinden.
Damit entstehen zwei unterschiedliche Verarbeitungspfade:
flowchart LR
    subgraph ING["Ingestion: bei Aufnahme oder Änderung"]
        direction TB
        A["Dokumente"] --> B["Parsing und Chunking"]
        B --> C["Embedding-Modell"]
        C --> D["Dokument-Embeddings"]
        D --> E[("Persistenter Vector Store")]
    end

    subgraph QUERY["Query: bei jeder Benutzeranfrage"]
        direction TB
        F["Benutzerfrage"] --> G["Embedding-Modell"]
        G --> H["Query-Embedding"]
        H --> I["Vektorsuche"]
        I --> J["Relevante Chunks"]
    end

    E --> I

    classDef input fill:#DBEAFE,stroke:#2563EB,color:#1E40AF
    classDef processing fill:#DCFCE7,stroke:#16A34A,color:#166534
    classDef retrieval fill:#FFEDD5,stroke:#EA580C,color:#9A3412
    classDef infrastructure fill:#F3F4F6,stroke:#6B7280,color:#374151

    class A,F input
    class B,C,D,G,H processing
    class I,J retrieval
    class E infrastructure

    style ING fill:#F0FDF4,stroke:#86EFAC,color:#166534
    style QUERY fill:#FFF7ED,stroke:#FDBA74,color:#9A3412
Die beiden Pfade unterscheiden sich grundlegend.
Ingestion verarbeitet die Dokumente unseres Wissensbestands. Dabei entstehen Chunks und ihre Embeddings, die wir dauerhaft speichern.
Query-Verarbeitung beginnt mit einer Benutzerfrage. Wir berechnen ein Query-Embedding und vergleichen es mit den bereits gespeicherten Dokument-Embeddings. Die passenden Chunks werden anschließend für die weitere RAG-Verarbeitung bereitgestellt.
Die Dokumente müssen dafür nicht erneut eingelesen, gechunkt oder eingebettet werden.
Diese Trennung ist eine der wichtigsten architektonischen Verbesserungen gegenüber unserem bisherigen RAG-Prototyp.
Embeddings sind abgeleitete Daten
Ein Embedding ersetzt nicht das ursprüngliche Dokument. Es ist eine numerische Repräsentation, die aus einem bestimmten Text mit einem bestimmten Embedding-Modell erzeugt wurde.
Ändert sich der für das Embedding verwendete Text, müssen wir das betroffene Embedding neu berechnen. Dasselbe gilt, wenn wir auf ein anderes Embedding-Modell wechseln.
Auch die Aufbereitung des Textes spielt eine Rolle. Ändern wir beispielsweise unsere Chunking-Strategie oder die Zusammensetzung des Embedding-Textes, können neue Embeddings erforderlich werden.
Eine neue Benutzerfrage ist dagegen kein Grund, sämtliche Dokument-Embeddings erneut zu erzeugen.
Warum wir einen Vector Store benötigen
Wir könnten unsere Embeddings grundsätzlich auch selbst speichern, beispielsweise in einer Datei oder einer relationalen Datenbank.
Für ein RAG-System benötigen wir jedoch mehr als eine dauerhafte Ablage von Zahlen.
Wir möchten die Embeddings zusammen mit ihren Dokumenttexten, IDs und Metadaten verwalten und bei einer Benutzeranfrage möglichst effizient nach ähnlichen Vektoren suchen.
Genau dafür verwenden wir einen Vector Store.
Im nächsten Abschnitt lernen wir mit Chroma ein System kennen, das diese Aufgaben übernimmt. Wir beginnen mit wenigen Beispieldaten und untersuchen, wie Dokumenttexte und Embeddings dauerhaft gespeichert werden können.
3.2 Was eine Vektordatenbank speichert
In Abschnitt 1.4 haben wir Embeddings zunächst als gewöhnliche Python-Listen behandelt. Das war ideal, um das Prinzip zu verstehen. Für eine dauerhafte RAG-Anwendung reicht eine Liste im Arbeitsspeicher jedoch nicht aus.
Wir möchten Embeddings dauerhaft speichern, verwalten und später effizient durchsuchen können. Dafür verwenden wir einen Vector Store.
Ein Vector Store speichert nicht nur Vektoren. Er verwaltet auch die Informationen, die wir benötigen, um einen gefundenen Vektor wieder einem konkreten Textabschnitt zuzuordnen.
Ein typischer Eintrag besteht aus vier Bestandteilen:
| Bestandteil | Aufgabe | Beispiel |
|---|---|---|
| ID | Identifiziert den Eintrag eindeutig | access-token |
| Dokumenttext | Enthält den ursprünglichen Text | Orbit access tokens are valid for 60 minutes. |
| Embedding | Numerische Repräsentation des Textes | [0.012, -0.034, ...] |
| Metadaten | Beschreiben zusätzliche Eigenschaften | {"topic": "authentication"} |
Das Embedding verwenden wir später für die semantische Suche. Der Dokumenttext liefert den Inhalt für unsere RAG-Antwort. IDs und Metadaten helfen uns, Einträge zu identifizieren, zu aktualisieren und gezielt auszuwählen.
Collections organisieren unsere Daten
In diesem Buch verwenden wir Chroma als Vector Store.
Chroma organisiert zusammengehörige Einträge in sogenannten Collections. Eine Collection lässt sich vereinfacht mit einer Tabelle in einer relationalen Datenbank vergleichen, auch wenn sich die zugrunde liegenden Datenmodelle unterscheiden.
Für unser erstes Experiment legen wir die Collection rag_basics an.
Darin speichern wir drei kurze Aussagen aus unserem Teralune-Beispiel:
documents = [
    "Orbit retries failed webhook deliveries for 72 hours.",
    "An Orbit 3 access token is valid for 60 minutes.",
    "Orbit retains telemetry data for 90 days.",
]
Jeder Text erhält eine eindeutige ID und passende Metadaten. Mit dem Embedding-Modell text-embedding-3-small erzeugen wir die zugehörigen Vektoren.
Anschließend speichern wir alle Informationen gemeinsam in Chroma.
Experiment 3.02: Texte und Embeddings dauerhaft speichern
Starte das Experiment aus dem Projektverzeichnis:
Das Programm erstellt beziehungsweise öffnet die Collection rag_basics, erzeugt Embeddings für unsere drei Beispielsätze und speichert die Einträge.
Der zentrale Speichervorgang verwendet upsert():
Die vier Argumente enthalten jeweils gleich lange Listen. Die Elemente an derselben Position gehören zusammen.
Was bedeutet upsert()?
Der Begriff setzt sich aus Update und Insert zusammen.
Existiert eine ID noch nicht, legt Chroma einen neuen Eintrag an. Ist die ID bereits vorhanden, aktualisiert Chroma den bestehenden Eintrag mit den übergebenen Daten.
Stabile IDs sind deshalb wichtig. Sie ermöglichen es uns, einen bestimmten Eintrag bei einem erneuten Indexierungslauf wiederzuerkennen.
Unser Laborlauf meldet:
Starte das Programm ein zweites Mal.
Die Collection enthält weiterhin drei Einträge. Dank upsert() wurden keine zusätzlichen Einträge mit denselben IDs angelegt.
Dabei müssen wir allerdings zwei Dinge unterscheiden:
upsert() verhindert Duplikate, aber nicht automatisch unnötige Embedding-Berechnungen.
Wenn unser Programm dieselben Texte vor jedem Speichervorgang erneut an das Embedding-Modell sendet, entstehen weiterhin API-Aufrufe. Um diese zu vermeiden, muss eine Ingestion-Pipeline zusätzlich erkennen, welche Dokumente neu sind oder sich verändert haben.
Wie die Daten in Chroma gelangen
Die Architektur unseres Experiments sieht folgendermaßen aus:
flowchart LR
    subgraph INPUT["Eingabedaten"]
        direction TB
        A["Dokumenttext"]
        B["ID und Metadaten"]
    end

    subgraph PROCESS["Verarbeitung"]
        direction TB
        C["Embedding-Modell"]
        D["Embedding"]
        C --> D
    end

    subgraph STORE["Persistente Speicherung"]
        direction TB
        E[("Chroma")]
        F["Collection: rag_basics"]
        E --- F
    end

    A --> C
    A --> E
    B --> E
    D --> E

    classDef input fill:#DBEAFE,stroke:#2563EB,color:#1E40AF
    classDef processing fill:#DCFCE7,stroke:#16A34A,color:#166534
    classDef infrastructure fill:#F3F4F6,stroke:#6B7280,color:#374151

    class A,B input
    class C,D processing
    class E,F infrastructure

    style INPUT fill:#EFF6FF,stroke:#93C5FD,color:#1E40AF
    style PROCESS fill:#F0FDF4,stroke:#86EFAC,color:#166534
    style STORE fill:#F8FAFC,stroke:#94A3B8,color:#334155
Der Dokumenttext wird durch das Embedding-Modell verarbeitet. Anschließend speichern wir das erzeugte Embedding gemeinsam mit dem Text, seiner ID und den Metadaten.
Persistente Speicherung mit Chroma
Für unsere Experimente verwenden wir den lokalen Chroma-Client:
Mit PersistentClient speichert Chroma seine Daten in einem lokalen Verzeichnis. Dieses Verzeichnis wird über CHROMA_DIR festgelegt.
Anders als unsere bisherigen Python-Listen bleiben die Daten nach dem Beenden des Programms erhalten.
Wenn wir das Skript erneut ausführen, kann Chroma auf dieselbe Collection zugreifen.
PersistentClient ist unser lokales Lab-Setup
In diesem Buch verwenden wir chromadb.PersistentClient, damit alle Experimente ohne zusätzlichen Datenbankserver auf einem einzelnen Rechner ausgeführt werden können.
Für produktive Anwendungen mit mehreren Prozessen, Benutzern oder Servern ist ein separat betriebener Chroma-Dienst in der Regel die geeignetere Architektur. Die Anwendung greift dann über einen Client auf den Vector Store zu, statt direkt dessen lokale Datendateien zu verwenden.
Dadurch lassen sich Anwendung und Datenbank unabhängig betreiben, aktualisieren und skalieren.
Unser lokales Setup ist deshalb eine bewusste didaktische Vereinfachung.
Was wir erreicht haben
Mit unserem ersten Chroma-Experiment können wir Texte, Embeddings und Metadaten gemeinsam speichern. Die Einträge bleiben nach einem Programmneustart erhalten, und stabile IDs verhindern bei wiederholter Ausführung unnötige Duplikate.
Das Experiment führt außerdem bereits eine erste Vektorsuche aus. Die dabei zurückgegebenen Distanzwerte betrachten wir ausführlich in Abschnitt 3.4.
Zunächst verschaffen wir uns jedoch einen Überblick über die verschiedenen Vector Stores, die für RAG-Systeme zur Verfügung stehen.
Dokumente aktualisieren
In der Praxis bleiben Dokumente nicht unverändert. Inhalte werden korrigiert, ergänzt oder entfernt. Solche Änderungen müssen auch im Vector Store berücksichtigt werden, damit die Vektorsuche nicht auf veraltete Informationen zugreift.
Chroma bietet dafür die Methoden update() und upsert():
update()aktualisiert einen bereits vorhandenen Eintrag anhand seiner ID.upsert()aktualisiert einen vorhandenen Eintrag oder legt ihn neu an, falls die ID noch nicht existiert.
Wenn sich der Text eines Chunks ändert, muss auch das zugehörige Embedding neu berechnet werden. In unserem Setup erzeugen wir die Embeddings selbst mit OpenAI und müssen deshalb bei einer Aktualisierung auch das neue Embedding übergeben.
Eine häufig verwendete Alternative besteht darin, alle bisherigen Chunks eines geänderten Dokuments zu löschen und das Dokument anschließend vollständig neu zu indexieren.
Das ist besonders dann sinnvoll, wenn sich durch Änderungen am Dokument auch die Anzahl oder die Grenzen der Chunks verschieben. So wird verhindert, dass nicht mehr benötigte Chunks im Vector Store zurückbleiben.
Diese Vorgehensweise ist einfach und zuverlässig, hat allerdings einen Nachteil: Zwischen dem Löschen und der erneuten Indexierung ist das Dokument vorübergehend nicht durchsuchbar.
Chroma erkennt Änderungen an den ursprünglichen Quelldateien nicht automatisch. Die Anwendung muss daher selbst feststellen, welche Dokumente verändert wurden, und die entsprechenden Aktualisierungen durchführen.
Wie sich solche Änderungen und unterschiedliche Dokumentversionen in größeren RAG-Systemen verwalten lassen, betrachten wir in einem späteren Kapitel.
3.3 Welche Vector Stores gibt es?
Chroma ist nur eine von mehreren Möglichkeiten, Embeddings zu speichern und zu durchsuchen. Die Systeme unterscheiden sich deutlich hinsichtlich Architektur, Betriebsmodell und zusätzlicher Suchfunktionen.
Für unser Verständnis genügt zunächst eine grobe Einordnung:
| System | Typischer Schwerpunkt |
|---|---|
| FAISS | performanter Vector Index als Library |
| Chroma | lokale Entwicklung, Prototyping und RAG |
| Qdrant | Vector Search, Filter und hybride Retrieval-Szenarien |
| Weaviate | Vector Search, BM25 und Hybrid Search |
| Milvus | große und verteilte Vector-Search-Systeme |
| Pinecone | verwalteter Vector Store in der Cloud |
| pgvector | Vektorsuche innerhalb von PostgreSQL |
| Elasticsearch | Full-Text Search, Vector Search und Hybrid Search |
FAISS nimmt dabei eine etwas andere Rolle ein als eine vollständige Vektordatenbank. Es stellt leistungsfähige Verfahren zur Vektorsuche bereit, überlässt viele Aufgaben der Datenhaltung jedoch der Anwendung.
Mit pgvector lassen sich Vektoren dagegen in einer bereits vorhandenen PostgreSQL-Infrastruktur verwalten. Andere Systeme sind stärker auf Vector Search als eigenständigen Dienst spezialisiert.
Für dieses Buch ist nicht entscheidend, welches Produkt in jeder denkbaren Situation gewinnt.
Wir verwenden Chroma nicht, weil es grundsätzlich die beste Vektordatenbank wäre. Für unser Lab hat es den Vorteil, dass Collections, Vektoren, Dokumenttexte, Metadaten, Filter und persistente Suche mit wenig Infrastruktur untersucht werden können. Die grundlegenden RAG-Konzepte sind nicht an Chroma gebunden.
Später werden wir außerdem sehen, dass semantische Vektorsuche nur eine Retrieval-Methode ist. Lexikalische und hybride Verfahren betrachten wir in Kapitel 4.
3.4 Von Similarity zu Distance
In Abschnitt 3.2 haben wir mit Chroma erstmals Texte, Embeddings und Metadaten dauerhaft gespeichert. Unser Experiment 02_chroma_basics.py führt anschließend auch eine semantische Suche über die gespeicherten Vektoren aus.
Jetzt betrachten wir diesen zweiten Teil des Experiments genauer.
Experiment 3.02: Die Distanzwerte verstehen
Starte das bereits bekannte Programm erneut:
Unsere Suchfrage lautet:
Das Programm erzeugt ein Query-Embedding und sucht in der Collection rag_basics nach den drei nächstgelegenen Vektoren.
Die Ausgabe unseres Laborlaufs:
Question: How long is an Orbit access token valid?

Results:

ID: access-token
Distance: 0.3158
Topic: authentication
Text: Orbit access tokens are valid for 60 minutes.

ID: telemetry-retention
Distance: 0.7920
Topic: telemetry
Text: Orbit retains telemetry data for 90 days.

ID: webhook-retries
Distance: 0.8884
Topic: webhooks
Text: Orbit retries failed webhook deliveries for 72 hours.
Der erste Treffer enthält genau die Information, die wir suchen: Ein Orbit Access Token ist 60 Minuten gültig.
Interessant sind jedoch die Zahlen, die Chroma zusätzlich zurückliefert.
Der passende Text besitzt eine Distanz von 0.3158. Die beiden anderen Texte liegen mit 0.7920 und 0.8884 deutlich weiter entfernt.
Warum ist ausgerechnet der kleinste Wert unser bester Treffer?
Similarity und Distance haben unterschiedliche Leserichtungen
In Abschnitt 1.5 haben wir die Cosine Similarity kennengelernt. Sie beschreibt die Ähnlichkeit zweier Vektoren anhand ihrer Richtung.
Bei einer Similarity gilt normalerweise:
Je größer der Wert, desto ähnlicher sind die Vektoren.
Chroma liefert uns dagegen einen Distanzwert.
Bei einer Distanz gilt die umgekehrte Leserichtung:
Je kleiner der Wert, desto näher liegen die Vektoren nach der verwendeten Metrik beieinander.
| Ergebnis | Distance | Rang |
|---|---|---|
| Access Token | 0.3158 | 1 |
| Telemetry Retention | 0.7920 | 2 |
| Webhook Retries | 0.8884 | 3 |
Deshalb steht access-token an erster Stelle.
Dabei ist wichtig, dass Nähe immer durch eine konkrete mathematische Metrik definiert wird. Unterschiedliche Metriken können dieselben Vektoren unterschiedlich bewerten.
Drei wichtige Metriken für die Vektorsuche
Bei der Arbeit mit Embeddings begegnen uns vor allem drei Metriken.
1. Cosine Similarity und Cosine Distance
Die Cosine Similarity betrachtet den Winkel zwischen zwei Vektoren. Sie misst damit vor allem, ob die Vektoren in dieselbe Richtung zeigen.
Die zugehörige Cosine Distance lässt sich häufig so berechnen:
$$ d_{\text{cosine}}(a,b)=1-\operatorname{cosine_similarity}(a,b) $$
Eine hohe Cosine Similarity entspricht damit einer kleinen Cosine Distance.
Bei der Cosine Similarity bedeutet ein Wert von 1, dass zwei von null verschiedene Vektoren in dieselbe Richtung zeigen. Die entsprechende Cosine Distance beträgt dann 0.
2. Euclidean Distance (L2)
Die euklidische Distanz beschreibt den geometrischen Abstand zwischen zwei Punkten im Vektorraum.
Für zwei Vektoren $a$ und $b$ gilt:
$$ d_{L2}(a,b)=\sqrt{\sum_{i=1}^{n}(a_i-b_i)^2} $$
Je kleiner der Abstand, desto näher liegen die beiden Punkte beieinander.
Manche Vector Stores verwenden statt der euklidischen Distanz deren Quadrat:
$$ d_{L2^2}(a,b)=\sum_{i=1}^{n}(a_i-b_i)^2 $$
Für das Ranking macht das bei denselben Vektoren keinen Unterschied: Die Quadratfunktion erhält die Reihenfolge nichtnegativer Abstände. Die ausgegebenen Zahlen unterscheiden sich allerdings.
3. Inner Product
Das Inner Product ist das Skalarprodukt zweier Vektoren:
$$ a\cdot b=\sum_{i=1}^{n}a_i b_i $$
Anders als die Cosine Similarity berücksichtigt es nicht nur die Richtung, sondern auch die Länge der Vektoren.
Bei auf Länge 1 normalisierten Vektoren entspricht das Inner Product der Cosine Similarity.
Ein Vector Store kann das Skalarprodukt intern in einen Distanzwert umrechnen, damit alle Suchergebnisse nach derselben Leserichtung sortiert werden können.
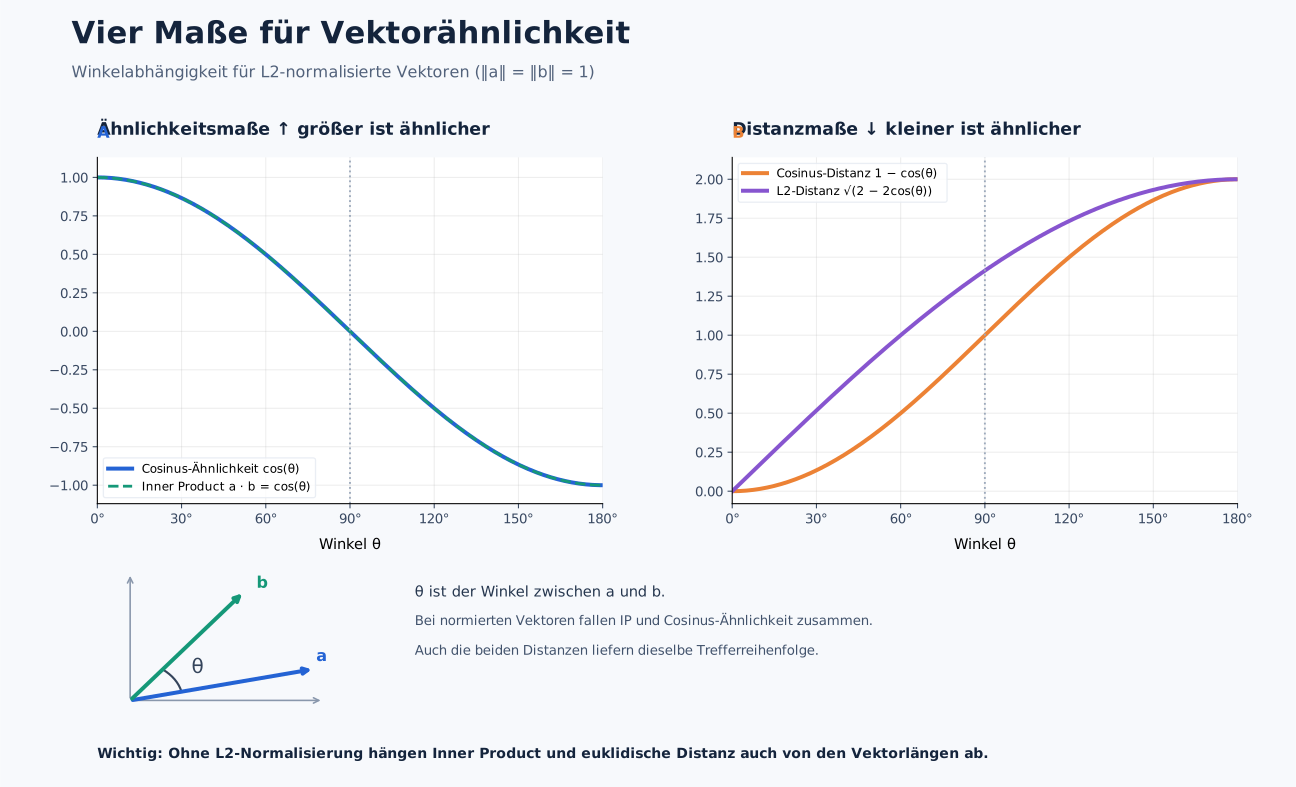
Welche Metrik verwendet Chroma?
Chroma unterstützt unter anderem L2, Cosine und Inner Product.
Für unsere Collection rag_basics haben wir keine abweichende Metrik festgelegt. Chroma verwendet deshalb die quadrierte euklidische Distanz (Squared L2).
Die ausgegebenen Werte 0.3158, 0.7920 und 0.8884 sind somit keine Cosine-Similarity-Werte.
Das ist eine wichtige Unterscheidung: Obwohl wir in Kapitel 1 mit Cosine Similarity gearbeitet haben, verwendet unser aktuelles Experiment eine andere Metrik.
Wir können die Distanzwerte deshalb nicht unmittelbar mit den Similarity-Werten aus Kapitel 1 vergleichen.
Distance ist nicht Similarity
Eine Distanz und eine Similarity besitzen unterschiedliche Leserichtungen.
Bei einer Distanz bedeutet ein kleinerer Wert normalerweise einen näheren Treffer. Bei einer Similarity bedeutet ein größerer Wert normalerweise eine höhere Ähnlichkeit.
Die konkreten Zahlen hängen außerdem von der verwendeten Metrik ab. Ein Distanzwert von 0.3158 bedeutet weder 31,58 % Ähnlichkeit noch eine Relevanzwahrscheinlichkeit von 68,42 %.
Auch Distanzwerte unterschiedlicher Metriken sollten nicht direkt miteinander verglichen werden.
Welche Distanzmetrik sollte man verwenden?
Die Wahl der Metrik hängt vom verwendeten Embedding-Modell ab.
- Cosine: Vergleicht die Richtung der Vektoren unabhängig von ihrer Länge. Häufig eine gute Wahl für semantische Textsuche.
- L2 (euklidische Distanz): Misst den geometrischen Abstand zwischen Vektoren. Bei normalisierten Embeddings liefert sie dieselbe Rangfolge wie Cosine.
- Inner Product (IP): Berücksichtigt sowohl die Richtung als auch die Länge der Vektoren. Kann sinnvoll sein, wenn das Embedding-Modell dafür trainiert wurde.
Für unser Experiment: Das OpenAI-Modell text-embedding-3-small liefert normalisierte Embeddings. Daher können wir problemlos die Standardeinstellung L2² von Chroma verwenden. Alle drei Verfahren liefern hier mathematisch dieselbe Rangfolge.
Grundsätzlich sollte man prüfen, welche Metrik der Hersteller des Embedding-Modells empfiehlt.
Was sagen uns die Distanzwerte wirklich?
Unser Experiment zeigt, dass Chroma den passenden Text über die Gültigkeit von Access Tokens an erster Stelle findet.
Das ist ein gutes Ergebnis. Trotzdem sollten wir die Distanz nicht mit einer fachlichen Bewertung verwechseln.
Ein kleiner Distanzwert bedeutet zunächst nur, dass zwei Embeddings nach der verwendeten Metrik nahe beieinanderliegen.
Er garantiert nicht, dass der gefundene Text aktuell, vollständig oder für die konkrete Benutzerfrage gültig ist.
Diese Unterscheidung wird später wichtig, wenn wir Dokumente aus verschiedenen Produktversionen durchsuchen. Zwei Dokumente können semantisch nahezu identisch sein und trotzdem unterschiedliche, möglicherweise veraltete Informationen enthalten.
Für den Moment genügt uns eine grundlegende Erkenntnis:
Die Vektorsuche liefert eine Rangfolge semantisch naher Texte. Ob diese Texte fachlich geeignet sind, müssen wir zusätzlich prüfen.
Im nächsten Abschnitt verlassen wir unsere drei Beispielsätze und indexieren erstmals die acht echten Dokument-Chunks aus Kapitel 2.
3.5 Chunks einmalig indexieren
In Abschnitt 3.2 haben wir drei kurze Beispielsätze in Chroma gespeichert. Damit kennen wir die grundlegenden Funktionen eines Vector Stores.
Jetzt verbinden wir die Dokumentverarbeitung aus Kapitel 2 mit unserer Vektordatenbank.
Wir verwenden erneut die beiden Teralune-Dokumente:
- D002: OAuth and API Keys
- D022: Pagination and cursors
Unser strukturorientierter Chunker erzeugt daraus acht Chunks. Diese möchten wir nun dauerhaft in Chroma indexieren.
Stabile IDs für unsere Chunks
Jeder Chunk benötigt eine eindeutige ID, damit wir ihn später wiederfinden und bei Bedarf aktualisieren können.
Für unsere beiden Dokumente verwenden wir folgende IDs:
D002-chunk-1
D002-chunk-2
D002-chunk-3
D022-chunk-1
D022-chunk-2
D022-chunk-3
D022-chunk-4
D022-chunk-5
Die ID setzt sich aus der Dokument-ID und der laufenden Chunk-Nummer zusammen.
Diese einfache Strategie reicht für unser Experiment aus. Bei einem erneuten Indexierungslauf können wir dieselben IDs verwenden und die vorhandenen Einträge mit upsert() aktualisieren.
Für produktive Systeme müssen wir allerdings berücksichtigen, dass sich Chunk-Grenzen bei einer Änderung des Dokuments verschieben können. Eine laufende Chunk-Nummer ist deshalb nicht zwangsläufig eine dauerhaft stabile Identität. Auch nicht mehr vorhandene Chunks müssen gegebenenfalls aus dem Index entfernt werden.
Überschriften gehören zum Embedding-Text
Beim Erzeugen der Embeddings verwenden wir nicht nur den eigentlichen Absatztext.
Wie bereits beim strukturorientierten Chunking in Abschnitt 2.6 berücksichtigen wir zusätzlich den Überschriftenpfad.
Dafür verwenden wir eine kleine Hilfsfunktion:
def embedding_text(chunk: Chunk) -> str:
    """Build the text representation used to create the embedding."""
    heading_path: str = " > ".join(chunk.headings)
    return f"{heading_path}\n\n{chunk.text}"
Aus einem Chunk entsteht damit beispielsweise folgende Textrepräsentation:
Der Überschriftenpfad liefert zusätzlichen semantischen Kontext.
Das ist besonders bei kurzen Abschnitten wichtig. Ein Absatz könnte beispielsweise nur beschreiben, unter welchen Bedingungen ein Cursor ungültig wird. Die Überschrift Cursor validity macht deutlich, zu welchem Thema diese Information gehört.
Indem wir Überschriften und Absatztext gemeinsam einbetten, stellen wir dem Embedding-Modell mehr Kontext zur Verfügung.
Embedding-Repräsentation bewusst gestalten
Der ursprüngliche Chunk und der Text, aus dem wir sein Embedding erzeugen, müssen nicht identisch sein.
Wir können beispielsweise Überschriften oder andere semantisch hilfreiche Informationen ergänzen.
Verwaltungsinformationen wie interne IDs oder Zugriffsrechte gehören dagegen in der Regel in die Metadaten. Sie müssen nicht automatisch Bestandteil des Embedding-Textes sein.
Entscheidend ist, welche Informationen die Bedeutung eines Textabschnitts für die spätere Suche verbessern.
Experiment 3.03: Dokument-Chunks in Chroma indexieren
Starte das Experiment aus dem Projektverzeichnis:
Das Programm führt die wesentlichen Schritte unserer bisherigen Dokumentverarbeitung zusammen:
- Es lädt die beiden Markdown-Dokumente D002 und D022.
- Es erzeugt mit dem strukturorientierten Chunker acht Chunks.
- Es ergänzt die Chunk-Texte um ihre Überschriftenpfade.
- Es berechnet die Embeddings mit
text-embedding-3-small. - Es speichert die Chunks zusammen mit ihren Embeddings und Metadaten in Chroma.
Als Ziel verwenden wir die Collection teralune_chunks.
Die Ausgabe unseres Laborlaufs lautet:
Collection: teralune_chunks
Documents processed: 2
Chunks indexed: 8
Chunks stored: 8

Indexed chunks:
D002-chunk-1 | OAuth and API Keys > Machine credentials
D002-chunk-2 | OAuth and API Keys > Claims and scopes
D002-chunk-3 | OAuth and API Keys > Rotation without interruption
D022-chunk-1 | Pagination and cursors > Cursor traversal
D022-chunk-2 | Pagination and cursors > Cursor traversal > Cursor validity
D022-chunk-3 | Pagination and cursors > Cursor traversal > Ordering and consistency
D022-chunk-4 | Pagination and cursors > Recover an interrupted traversal
D022-chunk-5 | Pagination and cursors > Query ownership and child pages
Chroma bestätigt, dass wir zwei Dokumente verarbeitet und insgesamt acht Chunks gespeichert haben.
Damit liegen unsere Dokument-Embeddings erstmals dauerhaft außerhalb des laufenden Python-Prozesses.
Indexierung ist nicht dasselbe wie Speicherung
Wir sollten an dieser Stelle zwei Vorgänge unterscheiden.
Embedding-Berechnung: Das Embedding-Modell erzeugt aus einem Text einen numerischen Vektor.
Indexierung: Wir übernehmen den Vektor zusammen mit dem zugehörigen Text und den Metadaten in unseren Vector Store, damit er später durchsucht werden kann.
Unser Experiment führt beide Vorgänge unmittelbar nacheinander aus.
Wenn wir das Skript erneut starten, werden die Embeddings in der aktuellen Implementierung erneut berechnet. Dank der stabilen IDs und upsert() entstehen dabei jedoch keine zusätzlichen Einträge mit denselben IDs.
Eine produktive Ingestion-Pipeline würde zusätzlich prüfen, welche Chunks neu sind oder sich verändert haben. Nur für diese müssten wir neue Embeddings erzeugen.
Das ist die eigentliche Konsequenz aus Abschnitt 3.1: Wir möchten Dokument-Embeddings wiederverwenden, statt sie bei jeder Benutzeranfrage neu zu berechnen.
Im nächsten Abschnitt setzen wir genau diese Trennung praktisch um. Wir starten ein eigenständiges Suchprogramm, das auf die bereits gespeicherten Chunks zugreift, ohne die Dokumente erneut einzulesen oder einzubetten.
3.6 Ingestion und Retrieval trennen
Im vorherigen Abschnitt haben wir acht Chunks aus den Teralune-Dokumenten D002 und D022 in Chroma gespeichert.
Bisher haben unsere RAG-Experimente die Dokumentverarbeitung und die Suche innerhalb desselben Programms durchgeführt. Bei jedem Start wurden die Dokumente erneut eingelesen, gechunkt und eingebettet.
Durch die persistente Speicherung können wir diese beiden Aufgaben jetzt voneinander trennen.
Die Ingestion bereitet den Wissensbestand vor. Das Retrieval greift auf diesen vorbereiteten Bestand zu.
Damit verändert sich nicht nur die Speicherung unserer Daten, sondern die Architektur des gesamten RAG-Systems.
Ein Suchprogramm ohne Dokumentverarbeitung
Unser nächstes Experiment verwendet die Collection teralune_chunks, die wir in Abschnitt 3.5 erstellt haben.
Das neue Programm benötigt weder den Pfad zu den Markdown-Dokumenten noch unseren Chunker. Es muss auch keine Dokument-Embeddings berechnen.
Stattdessen öffnet es die bereits vorhandene Collection:
Die Konstante COLLECTION_NAME enthält den Wert teralune_chunks.
Anschließend erzeugen wir ein Embedding für die Benutzerfrage:
Dieses Query-Embedding übergeben wir an Chroma:
Mit n_results legen wir fest, wie viele Treffer Chroma maximal zurückgeben soll.
In unserem Experiment verwenden wir TOP_K = 3.
Damit besteht die Suche aus nur drei wesentlichen Schritten: Collection öffnen, Benutzerfrage einbetten und ähnliche Chunks abrufen.
Die Dokumentverarbeitung ist daran nicht mehr beteiligt.
Experiment 3.04: Gespeicherte Chunks durchsuchen
Für dieses Experiment muss die Collection teralune_chunks bereits existieren.
Falls du das vorherige Experiment noch nicht ausgeführt hast, starte zunächst die Indexierung:
Anschließend führen wir unser Suchprogramm aus:
Wir stellen folgende Frage:
Die Frage bezieht sich auf die Gültigkeitsdauer eines Cursors. Wir möchten wissen, was passiert, wenn ein Client seine Verarbeitung für 20 Minuten unterbricht.
Unser Laborlauf beginnt mit folgender Ausgabe:
Collection: teralune_chunks
Stored chunks: 8
Question: The reader paused for 20 minutes. What happens to the cursor?
Top k: 3
Chroma hat die bereits gespeicherte Collection geöffnet. Sie enthält weiterhin unsere acht Chunks.
Die Suche liefert folgende Rangfolge:
| Rang | Chunk | Distance | Überschrift |
|---|---|---|---|
| 1 | D022-chunk-2 |
0.8697 | Cursor validity |
| 2 | D022-chunk-1 |
1.0455 | Cursor traversal |
| 3 | D022-chunk-4 |
1.0632 | Recover an interrupted traversal |
Alle drei Treffer stammen aus dem Dokument D022 (Pagination and cursors).
Der erste Treffer enthält die entscheidende Information:
A cursor expires after 15 minutes and is bound to workspace,
filters and sort order. An expired cursor requires a new traversal.
Ein Cursor läuft also nach 15 Minuten ab.
Wenn der Client seine Verarbeitung für 20 Minuten unterbricht, ist der bisherige Cursor nicht mehr gültig. Der Client muss eine neue Traversierung beginnen.
Der gefundene Chunk enthält außerdem einen wichtigen Hinweis: Ein abgelaufener Cursor sollte nicht einfach wiederholt verwendet werden.
Die beiden weiteren Treffer liefern ergänzende Informationen zur Cursor-Verarbeitung und zur Wiederaufnahme unterbrochener Traversierungen.
Unser Retrieval hat damit den relevanten Abschnitt gefunden, ohne die ursprünglichen Markdown-Dokumente erneut zu verarbeiten.
Zwei getrennte Pipelines
Unser RAG-System besteht jetzt aus zwei unabhängig ausführbaren Verarbeitungspfaden.
Die Ingestion-Pipeline verarbeitet Dokumente, erzeugt Chunks und Embeddings und speichert sie in Chroma.
Die Query-Pipeline verarbeitet Benutzerfragen und durchsucht die bereits gespeicherten Embeddings.
flowchart TB
subgraph ING["Ingestion: bei Aufnahme oder Änderung"]
direction LR
A["Dokumente"] --> B["Parsing"]
B --> C["Chunking"]
C --> D["Dokument-Embeddings"]
D --> E[("Chroma")]
end
subgraph QUERY["Query: bei jeder Anfrage"]
direction LR
F["Benutzerfrage"] --> G["Query-Embedding"]
G --> H["Vektorsuche"]
H --> I["Top-k Chunks"]
end
E --> H
classDef input fill:#DBEAFE,stroke:#2563EB,color:#1E40AF
classDef processing fill:#DCFCE7,stroke:#16A34A,color:#166534
classDef retrieval fill:#FFEDD5,stroke:#EA580C,color:#9A3412
classDef infrastructure fill:#F3F4F6,stroke:#6B7280,color:#374151
class A,F input
class B,C,D,G processing
class H,I retrieval
class E infrastructure
style ING fill:#F0FDF4,stroke:#86EFAC,color:#166534
style QUERY fill:#FFF7ED,stroke:#FDBA74,color:#9A3412Der entscheidende Unterschied liegt darin, wann die beiden Pipelines ausgeführt werden.
Die Ingestion wird benötigt, wenn neue Dokumente aufgenommen oder vorhandene Inhalte verändert werden. Sie kann beispielsweise durch einen Datei-Upload, einen geplanten Hintergrundprozess oder eine Änderung im Dokumentenmanagement ausgelöst werden.
Die Query-Pipeline läuft dagegen bei jeder Benutzeranfrage.
Für unsere aktuelle Frage wurde deshalb nur ein neues Embedding berechnet: das Query-Embedding.
Die acht Dokument-Embeddings wurden wiederverwendet.
Das reduziert die Anzahl unnötiger API-Aufrufe und verhindert, dass Benutzeranfragen auf die erneute Verarbeitung des gesamten Dokumentbestands warten müssen.
Unabhängige Ausführung bedeutet nicht unabhängige Daten
Ingestion und Retrieval sind getrennte Verarbeitungspfade, verwenden aber denselben Vector Store.
Die Query-Pipeline ist deshalb weiterhin darauf angewiesen, dass die benötigte Collection existiert und passende Dokument-Embeddings enthält.
In einer produktiven Anwendung müssen wir außerdem sicherstellen, dass Änderungen am Wissensbestand zuverlässig in den Index übernommen werden.
Was bedeutet Top-k?
Unsere Suche verwendet:
Damit fordern wir die drei nach der verwendeten Distanzmetrik nächstgelegenen Kandidaten an.
Das bedeutet allerdings nicht, dass genau drei relevante Chunks existieren.
Ein Treffer kann semantisch ähnlich sein, ohne die Frage tatsächlich zu beantworten. Umgekehrt können weitere relevante Chunks außerhalb der ersten drei Ergebnisse liegen.
Top-k begrenzt die Anzahl der zurückgegebenen Kandidaten. Es garantiert weder deren Relevanz noch deren Vollständigkeit.
Wie wir Retrieval-Ergebnisse systematisch bewerten und verschiedene Suchverfahren kombinieren können, untersuchen wir in Kapitel 4.
Was wir erreicht haben
Mit diesem Experiment haben wir einen wichtigen Architekturbaustein unseres RAG-Systems umgesetzt.
Unser Suchprogramm benötigt keine Dokumentdateien und keinen Chunker mehr. Es verwendet ausschließlich die persistente Chroma-Collection und berechnet für jede Benutzerfrage ein neues Query-Embedding.
Damit sind Ingestion und Retrieval erstmals praktisch voneinander getrennt.
Bisher durchsuchen wir allerdings immer alle acht gespeicherten Chunks.
Im nächsten Abschnitt untersuchen wir, wie sich der Suchraum mithilfe von Metadaten gezielt einschränken lässt.
3.7 Metadaten begrenzen den Suchraum
Bisher haben wir unsere gespeicherten Chunks ausschließlich anhand ihrer Embeddings durchsucht. Chroma hat dabei diejenigen Texte zurückgegeben, deren Vektoren der Benutzerfrage am nächsten liegen.
Für viele RAG-Anwendungen reicht das jedoch nicht aus.
Embeddings beschreiben semantische Ähnlichkeit. Ob ein Dokument zu einer bestimmten Produktversion gehört, für einen Benutzer zugänglich ist oder überhaupt noch gültig ist, lässt sich daraus nicht zuverlässig ableiten.
Solche Eigenschaften müssen wir ausdrücklich berücksichtigen.
Dafür verwenden wir Metadatenfilter.
Eine absichtlich mehrdeutige Frage
Betrachten wir folgende Benutzerfrage:
Die Frage ist unvollständig. Ohne zusätzlichen Kontext wissen wir nicht, worauf sich it bezieht.
In unserem kleinen Teralune-Corpus kommen mehrere Dinge vor, die eine Gültigkeitsdauer besitzen. Beispielsweise Access Tokens und Cursors.
Eine rein semantische Suche muss trotzdem eine Rangfolge erzeugen. Sie kann jedoch nicht wissen, welches Objekt der Benutzer tatsächlich meint.
Nehmen wir nun an, unsere Anwendung kennt den aktuellen Kontext: Der Benutzer arbeitet gerade mit dem Dokument D022 über Pagination und Cursors.
Dann können wir die Suche auf dieses Dokument begrenzen.
Experiment 3.05: Ungefilterte und gefilterte Suche vergleichen
Wir verwenden erneut die bereits gespeicherte Collection teralune_chunks.
Falls sie noch nicht existiert, muss zunächst das Indexierungsskript aus Abschnitt 3.5 ausgeführt werden.
Starte anschließend unser Experiment:
Das Programm erzeugt ein Embedding für die Benutzerfrage und führt damit zwei Suchvorgänge aus:
- Eine ungefilterte Suche über die gesamte Collection.
- Eine Suche, die ausschließlich Chunks aus D022 berücksichtigt.
Für beide Suchvorgänge verwenden wir dasselbe Query-Embedding.
Die ungefilterte Suche sieht im Python-Code so aus:
Für die zweite Suche ergänzen wir den Parameter where:
filtered_results = collection.query(
query_embeddings=[query_embedding],
n_results=TOP_K,
where={"document_id": "D022"},
)
Damit berücksichtigt Chroma nur Einträge, deren Metadatenfeld document_id den Wert D022 besitzt.
Die eigentliche Benutzerfrage bleibt unverändert.
Was verändert der Filter?
Unser Laborlauf liefert folgende Ergebnisse:
Question: How long is it valid?
Unfiltered search:
1. D022-chunk-2 | distance=1.2869 | Pagination and cursors > Cursor traversal > Cursor validity
2. D002-chunk-2 | distance=1.4535 | OAuth and API Keys > Claims and scopes
3. D002-chunk-1 | distance=1.5174 | OAuth and API Keys > Machine credentials
Filtered to D022:
1. D022-chunk-2 | distance=1.2869 | Pagination and cursors > Cursor traversal > Cursor validity
2. D022-chunk-4 | distance=1.6559 | Pagination and cursors > Recover an interrupted traversal
3. D022-chunk-1 | distance=1.7013 | Pagination and cursors > Cursor traversal
Die Ergebnisse lassen sich übersichtlich vergleichen:
| Rang | Ohne Filter | Distance | Mit Filter D022 |
Distance |
|---|---|---|---|---|
| 1 | D022-chunk-2 |
1.2869 | D022-chunk-2 |
1.2869 |
| 2 | D002-chunk-2 |
1.4535 | D022-chunk-4 |
1.6559 |
| 3 | D002-chunk-1 |
1.5174 | D022-chunk-1 |
1.7013 |
Ohne Filter erscheinen neben dem passenden Cursor-Abschnitt auch zwei Chunks aus dem OAuth-Dokument D002.
Das ist nachvollziehbar: Auch dort geht es um zeitlich begrenzte Berechtigungen und damit um ein semantisch verwandtes Thema.
Nach dem Filtern stammen dagegen alle drei Treffer aus D022.
Besonders interessant ist der erste Treffer.
Seine Distanz beträgt vor dem Filtern 1.2869 und danach ebenfalls 1.2869.
Das ist kein Zufall.
Wir haben weder das Query-Embedding noch das Dokument-Embedding verändert. Auch die verwendete Distanzmetrik ist gleich geblieben.
Der Filter hat lediglich festgelegt, welche Einträge überhaupt als Suchergebnis infrage kommen.
Semantische Ähnlichkeit und Metadatenfilter erfüllen unterschiedliche Aufgaben
Wir können uns die gefilterte Suche als zwei Bedingungen vorstellen:
- Ein Chunk muss die Metadatenbedingungen erfüllen.
- Unter den zulässigen Chunks suchen wir die semantisch nächsten Treffer.
Das folgende Diagramm verdeutlicht den Unterschied:
flowchart LR
Q["Benutzerfrage"] --> E["Query-Embedding"]
subgraph STORE["Chroma: teralune_chunks"]
direction TB
A["8 gespeicherte Chunks"]
B["Metadatenfilter<br/>document_id = D022"]
C["5 zulässige Chunks"]
A --> B --> C
end
E --> S["Vektorsuche"]
C --> S
S --> R["Top 3 Treffer<br/>ausschließlich aus D022"]
classDef input fill:#DBEAFE,stroke:#2563EB,color:#1E40AF
classDef processing fill:#DCFCE7,stroke:#16A34A,color:#166534
classDef retrieval fill:#FFEDD5,stroke:#EA580C,color:#9A3412
classDef infrastructure fill:#F3F4F6,stroke:#6B7280,color:#374151
class Q input
class E processing
class B,S,R retrieval
class A,C infrastructure
style STORE fill:#F8FAFC,stroke:#94A3B8,color:#374151Der Metadatenfilter begrenzt die Menge der zulässigen Kandidaten. Innerhalb dieser Menge bestimmt die Vektorsuche die Rangfolge.
Dabei sollten wir nicht annehmen, dass Chroma technisch zwingend zuerst eine vollständige Liste aller passenden Einträge erstellt. Das Diagramm zeigt die logische Wirkung des Filters, nicht die interne Implementierung des Suchalgorithmus.
Metadatenfilter und semantische Suche
Metadatenfilter verbessern nicht unmittelbar die semantische Repräsentation einer Benutzerfrage.
Sie schränken anhand expliziter Bedingungen ein, welche Dokumente oder Chunks als Treffer infrage kommen.
Dadurch können die Ergebnisse fachlich passender werden, obwohl sich weder die Embeddings noch die Distanzberechnung verändern.
Welche Metadaten sind für RAG wichtig?
Unser Experiment verwendet lediglich die Dokument-ID.
In realistischen RAG-Systemen können wir jedoch wesentlich mehr Eigenschaften berücksichtigen:
| Metadatum | Beispiel | Verwendung |
|---|---|---|
| Dokument-ID | D022 |
Suche auf ein bestimmtes Dokument begrenzen |
| Produktversion | 3.0 |
Nur Informationen zur gewünschten Version verwenden |
| Sprache | de |
Dokumente einer bestimmten Sprache auswählen |
| Dokumentstatus | current |
Veraltete Dokumente ausschließen |
| Organisation | customer_42 |
Daten einem Mandanten zuordnen |
| Zugriffsklasse | INTERNAL |
Zugriff auf geschützte Inhalte kontrollieren |
Besonders wichtig sind Produktversionen und Dokumentstatus.
Ein semantisch sehr ähnlicher Treffer kann fachlich falsch sein, wenn er sich auf eine ältere Produktversion bezieht. Ein Metadatenfilter kann solche Dokumente bereits vor der Ergebnisbewertung ausschließen.
Diesen Fall untersuchen wir später in Abschnitt 3.11.
Metadatenfilter und Zugriffskontrolle
Metadatenfilter können auch bei der Zugriffskontrolle eine Rolle spielen. Hier müssen wir allerdings besonders sorgfältig unterscheiden.
Ein Embedding enthält keine verlässliche Information darüber, ob ein Benutzer auf ein Dokument zugreifen darf.
Die Entscheidung über Zugriffsrechte muss deshalb unabhängig von der semantischen Ähnlichkeit getroffen werden.
Zugriffsrechte sind kein Ähnlichkeitsproblem
Ob ein Benutzer ein Dokument lesen darf, ist eine deterministische Sicherheitsentscheidung.
Ein Metadatenfilter kann Bestandteil der technischen Durchsetzung dieser Entscheidung sein. Dafür muss die Anwendung jedoch die Identität und Berechtigungen des Benutzers zuverlässig prüfen und daraus die zulässigen Filterbedingungen ableiten.
Benutzer dürfen sicherheitsrelevante Filter nicht beliebig selbst festlegen oder umgehen können.
Eine belastbare Zugriffskontrolle muss außerdem verhindern, dass geschützte Inhalte über andere Abfragen oder Verarbeitungsschritte zugänglich werden.
In unserem Experiment verwenden wir Metadatenfilter ausschließlich, um das Retrieval-Verhalten zu untersuchen. Die vollständige Umsetzung einer Zugriffskontrolle ist nicht Gegenstand dieses Beispiels.
Was wir erreicht haben
Mit unserem fünften Experiment haben wir die Vektorsuche um eine wichtige Fähigkeit erweitert.
Wir können jetzt nicht nur nach semantisch ähnlichen Texten suchen, sondern den Suchraum anhand strukturierter Eigenschaften begrenzen.
Dabei haben wir gesehen, dass ein Filter die Distanz eines einzelnen Treffers nicht verändert. Er entscheidet vielmehr darüber, welche Chunks überhaupt berücksichtigt werden.
Bislang stammen unsere Metadaten direkt aus der Dokumentverarbeitung. Für größere Wissensbestände benötigen wir jedoch zusätzliche Informationen wie Produktversion, Dokumentstatus und Zugriffsklasse.
Im nächsten Abschnitt untersuchen wir deshalb, woher diese Dokumentmetadaten kommen und warum sie nicht vom Chunker selbst erzeugt werden sollten.
3.8 Dokumentmetadaten gehören nicht in den Chunker
Im vorherigen Abschnitt haben wir gesehen, wie Metadaten den Suchraum einer Vektordatenbank einschränken können. Bisher verwendeten wir dafür lediglich die Dokument-ID.
Für realistische RAG-Systeme benötigen wir jedoch weitere Informationen. Beispielsweise müssen wir wissen, zu welcher Produktversion ein Dokument gehört, ob es noch aktuell ist und welche Zugriffsklasse es besitzt.
Woher kommen diese Informationen?
Dokumentinhalt und Dokumentmetadaten unterscheiden
Einige Eigenschaften lassen sich scheinbar einfach aus der Verzeichnisstruktur ableiten. Eine Datei unter corpus/public/ ist beispielsweise offensichtlich als öffentlich vorgesehen.
Das kann für einen kleinen, kontrollierten Corpus funktionieren. Als allgemeine Lösung ist es jedoch problematisch.
Ein Dateipfad ist zunächst nur ein Speicherort. Er ist keine verlässliche Quelle für fachliche Gültigkeit, Produktversionen oder Zugriffsberechtigungen.
Unser Teralune-Corpus besitzt deshalb ein separates Dokumentmanifest.
Darin werden die Eigenschaften jedes Dokuments ausdrücklich festgelegt. Ein Eintrag sieht beispielsweise so aus:
{
"id": "D002",
"title": "OAuth and API Keys",
"product": "orbit",
"version": "3.0",
"language": "en",
"access": "PUBLIC",
"document_type": "reference",
"status": "current",
"authority": "official"
}
Das Manifest enthält Informationen, die wir nicht zuverlässig aus dem Dokumenttext oder seinem Embedding ableiten können.
Beispielsweise bedeutet version: "3.0", dass das Dokument der Produktversion 3.0 zugeordnet ist. Mit status: "current" kennzeichnen wir es als aktuell.
Das Feld authority: "official" beschreibt seine Herkunft beziehungsweise seinen Autoritätsstatus innerhalb unseres Corpus.
Diese Eigenschaften werden ausdrücklich gepflegt und nicht vom Embedding-Modell geschätzt.
Autoritative Metadaten
Als autoritative Metadaten bezeichnen wir Informationen, die aus einer dafür festgelegten, verlässlichen Quelle stammen.
In unserem Beispiel ist das Dokumentmanifest diese Quelle.
Der Chunker darf deshalb nicht eigenständig entscheiden, ob ein Dokument aktuell, offiziell oder öffentlich zugänglich ist. Er übernimmt diese Eigenschaften aus dem Manifest.
In einer produktiven Anwendung könnte die autoritative Quelle beispielsweise ein Dokumentenmanagementsystem, ein Produktkatalog oder ein Berechtigungssystem sein.
Der Chunker verarbeitet Textstrukturen
Unser Chunker aus Kapitel 2 hat eine klar definierte Aufgabe: Er zerlegt Dokumentinhalte in sinnvolle Textabschnitte und erhält dabei ihre Struktur.
Dafür verwenden wir weiterhin unseren bekannten Datentyp:
@dataclass
class Chunk:
"""Represents a text chunk and its structural metadata."""
document_id: str
chunk_number: int
source: str
headings: list[str]
text: str
Der Chunk enthält die Informationen, die unmittelbar mit der Textverarbeitung zusammenhängen.
Er kennt seine Dokument-ID, seine Position im Dokument, den Quellpfad, den Überschriftenpfad und seinen Text.
Er muss dagegen nicht selbst ermitteln, welche Produktversion gültig ist oder welche Benutzer auf das Dokument zugreifen dürfen.
Damit bleibt der Chunker unabhängig von den fachlichen Regeln unseres Dokumentbestands.
Metadaten beim Indexieren ergänzen
Erst bei der Indexierung verbinden wir die erzeugten Chunks mit den zugehörigen Dokumentmetadaten.
Dafür lesen wir anhand der Dokument-ID den passenden Eintrag aus dem Manifest:
Anschließend übernehmen wir die Eigenschaften, die wir für unsere Retrieval-Experimente benötigen:
metadatas.append(
{
"document_id": chunk.document_id,
"chunk_number": chunk.chunk_number,
"version": document_metadata["version"],
"language": document_metadata["language"],
"access": document_metadata["access"],
"status": document_metadata["status"],
"authority": document_metadata["authority"],
"document_type": document_metadata["document_type"],
}
)
Damit erhält jeder indexierte Chunk neben seinen strukturellen Informationen auch die fachlichen Eigenschaften seines Quelldokuments.
Für unser aktuelles Retrieval verwenden wir sechs zusätzliche Metadatenfelder:
| Feld | Bedeutung |
|---|---|
version |
Zugehörige Produktversion |
language |
Sprache des Dokuments |
access |
Zugriffsklasse |
status |
Dokumentstatus |
authority |
Autoritätsstatus der Quelle |
document_type |
Art des Dokuments |
Diese Felder können wir später mit Chroma gezielt filtern.
Beispielsweise können wir ausschließlich Dokumente berücksichtigen, die zur Produktversion 3.0 gehören und den Status current besitzen.
Warum diese Trennung wichtig ist
Die Trennung zwischen Chunking und Dokumentmetadaten hat einen wesentlichen Vorteil: Beide Informationen können unabhängig voneinander verwaltet werden.
Wenn sich beispielsweise der Status eines Dokuments von current auf historical ändert, muss sich sein eigentlicher Text nicht verändert haben.
Wir müssen deshalb nicht zwangsläufig neue Chunks oder Embeddings erzeugen. Stattdessen können wir die betroffenen Metadaten im Vector Store aktualisieren.
Umgekehrt kann sich der Dokumentinhalt ändern, ohne dass seine Produktversion oder Zugriffsklasse angepasst werden muss.
Diese Unabhängigkeit vermeidet unnötige Verarbeitungsschritte und sorgt für eine klarere Architektur.
Unser Teralune-Corpus enthält noch weitere Metadaten, beispielsweise Organisationen, Teams und benötigte Rollen. Diese benötigen wir für die aktuellen Experimente nicht.
Sie werden später relevant, wenn wir Zugriffskontrolle und Mandantentrennung als eigenständige Bestandteile unserer RAG-Architektur betrachten.
Im nächsten Abschnitt führen wir die bisher getrennt betrachteten Bausteine zusammen: Wir verarbeiten einen größeren Teil des Teralune-Corpus, ergänzen die Dokumentmetadaten aus dem Manifest und speichern die Ergebnisse in Chroma.
3.9 Einen realistischen Corpus indexieren
Bisher haben wir lediglich zwei Teralune-Dokumente mit insgesamt acht Chunks indexiert. Das war ausreichend, um die grundlegenden Funktionen von Chroma kennenzulernen.
Jetzt erweitern wir unser Experiment auf einen größeren Dokumentbestand.
Dabei verbinden wir die bisherigen Bausteine zu einer vollständigen Indexierungspipeline: Wir laden Dokumente, erzeugen strukturorientierte Chunks, ergänzen die Metadaten aus dem Dokumentmanifest, berechnen Embeddings und speichern alles in Chroma.
Das Ergebnis ist eine persistente Collection, die wir in den folgenden Retrieval-Experimenten wiederverwenden.
Welche Dokumente indexieren wir?
Unser Teralune-Corpus enthält insgesamt 48 Dokumente in verschiedenen Dateiformaten, darunter Markdown, HTML, CSV, PDF und DOCX.
Für dieses Experiment beschränken wir uns bewusst auf die 36 Markdown-Dokumente.
Die Verarbeitung unterschiedlicher Dateiformate haben wir bereits in Abschnitt 2.9 untersucht. Jetzt möchten wir uns auf die Indexierung und die anschließende Vektorsuche konzentrieren.
Unser Skript sucht deshalb ausschließlich nach Markdown-Dateien:
Mit rglob("*.md") durchsuchen wir das Corpus-Verzeichnis rekursiv. sorted() sorgt dafür, dass die Dateien in einer reproduzierbaren Reihenfolge verarbeitet werden.
Dabei ist wichtig, dass wir ausschließlich das Verzeichnis corpus/ durchsuchen.
Unser Teralune-Projekt enthält zusätzlich Evaluationsdaten, Autorenmaterial und andere Hilfsdateien. Diese gehören nicht automatisch zum Wissensbestand, den unser RAG-System durchsuchen soll.
Die Trennung der Verzeichnisse verhindert, dass solche Materialien versehentlich als Retrieval-Quellen indexiert werden.
Dokumente und Metadaten zusammenführen
Wie in Abschnitt 3.8 beschrieben, stammen die fachlichen Dokumentmetadaten aus einem separaten Manifest.
Unser Indexierungsskript lädt dieses Manifest zunächst in ein Dictionary, dessen Schlüssel die Dokument-IDs sind.
Für jede Markdown-Datei prüfen wir anschließend, ob ein entsprechender Manifest-Eintrag existiert:
document_id: str = document_file.stem
if document_id not in manifest:
raise ValueError(
f"Document {document_id} is missing from the manifest."
)
Fehlt der Eintrag, bricht das Programm mit einer Fehlermeldung ab.
Das ist eine bewusste Entscheidung. Wir möchten keine Dokumente indexieren, deren Produktversion, Status oder Zugriffsklasse unbekannt sind.
Anschließend lesen wir den Dokumenttext und erzeugen die strukturierten Chunks:
text: str = document_file.read_text(encoding="utf-8")
chunks.extend(
structure_chunks(
text,
document_file,
)
)
Wie in unseren bisherigen Experimenten berücksichtigen wir beim Embedding auch den Überschriftenpfad.
Die fachlichen Metadaten ergänzen wir dagegen erst beim Aufbau der Chroma-Einträge.
Ein Ausschnitt aus dem Indexierungscode zeigt diese Trennung:
document_metadata: dict[str, Any] = manifest[chunk.document_id]
metadatas.append(
{
"document_id": chunk.document_id,
"chunk_number": chunk.chunk_number,
"source": chunk.source,
"headings": " > ".join(chunk.headings),
"version": document_metadata["version"],
"language": document_metadata["language"],
"access": document_metadata["access"],
"status": document_metadata["status"],
"authority": document_metadata["authority"],
"document_type": document_metadata["document_type"],
}
)
Damit besitzt jeder Chunk sowohl strukturelle Informationen aus der Dokumentverarbeitung als auch fachliche Eigenschaften aus dem Manifest.
Wir müssen diese Informationen später nicht erneut aus dem ursprünglichen Dokument ermitteln.
Embeddings erzeugen und speichern
Nachdem alle Markdown-Dokumente verarbeitet wurden, erstellen wir die Embeddings.
Dafür sammeln wir zunächst die Texte, die an das Embedding-Modell übergeben werden sollen:
Anschließend erzeugen wir die Embeddings mit einem gemeinsamen API-Aufruf:
Unsere Hilfsfunktion embed() verwendet weiterhin text-embedding-3-small.
Anders als in den ersten Experimenten übergeben wir jetzt eine Liste von Texten. Die Embedding-API kann mehrere Eingabetexte innerhalb einer Anfrage verarbeiten.
Das reduziert die Anzahl einzelner API-Aufrufe. Die Anzahl der zu verarbeitenden Token und die damit verbundenen Kosten verschwinden dadurch allerdings nicht.
Die fertigen Einträge speichern wir in einer neuen Chroma-Collection:
collection = chroma_client.get_or_create_collection(
name=COLLECTION_NAME,
)
collection.upsert(
ids=ids,
documents=texts,
embeddings=embeddings,
metadatas=metadatas,
)
Die Collection erhält den Namen teralune_corpus.
Wir verwenden bewusst eine andere Collection als in den bisherigen Experimenten. teralune_chunks enthält weiterhin unsere acht Beispiel-Chunks, während teralune_corpus den größeren Markdown-Bestand aufnimmt.
Experiment 3.06: Den Teralune-Corpus indexieren
Jetzt führen wir die vollständige Indexierung aus.
Starte das Skript aus dem Projektverzeichnis:
Wichtig: Das Experiment erzeugt Embeddings für sämtliche gefundenen Chunks und verwendet dafür die OpenAI API. Der erste Indexierungslauf kann deshalb Kosten verursachen.
Unser Laborlauf liefert folgende Ausgabe:
Markdown documents found: 36
Chunks created: 115
Creating embeddings...
Collection: teralune_corpus
Chunks stored: 115
Access levels:
CUSTOMER: 17 chunks
INTERNAL: 12 chunks
PUBLIC: 81 chunks
RESTRICTED: 5 chunks
Das Programm hat 36 Markdown-Dokumente gefunden und daraus 115 Chunks erzeugt.
Anschließend wurden die Embeddings berechnet und gemeinsam mit den Texten und Metadaten in Chroma gespeichert.
Die Collection teralune_corpus enthält jetzt 115 persistente Retrieval-Einheiten.
Noch nicht der gesamte Corpus
Der Teralune-Corpus umfasst insgesamt 48 Dokumente. Unser Experiment indexiert ausschließlich die 36 Markdown-Dokumente.
Die übrigen HTML-, CSV-, PDF- und DOCX-Dateien sind nicht Bestandteil dieser Collection.
Die Zahl 115 beschreibt deshalb die Chunks unseres aktuellen Markdown-Index und nicht den vollständigen Teralune-Corpus.
Unterschiedliche Zugriffsklassen im selben Index
Interessant ist auch die Verteilung der Zugriffsklassen:
| Zugriffsklasse | Chunks |
|---|---|
PUBLIC |
81 |
CUSTOMER |
17 |
INTERNAL |
12 |
RESTRICTED |
5 |
| Gesamt | 115 |
Damit enthält unsere Collection nicht nur unterschiedliche Themen und Dokumentversionen, sondern auch Inhalte mit verschiedenen Zugriffsklassen.
Für die folgenden Retrieval-Experimente ist das nützlich. Wir können untersuchen, wie sich semantische Suche verhält, wenn Dokumente mit unterschiedlichen fachlichen Eigenschaften im selben Index liegen.
Die bloße Speicherung dieser Zugriffsklassen stellt allerdings noch keine Zugriffskontrolle dar.
Chroma verhindert in unserem aktuellen Laboraufbau nicht automatisch, dass eine Suche auch interne oder eingeschränkte Dokumente zurückliefert.
Die Berechtigung eines Benutzers muss vor der Freigabe entsprechender Inhalte zuverlässig geprüft und technisch durchgesetzt werden.
Unsere aktuelle Collection dient ausschließlich als kontrollierte Experimentierumgebung.
Was enthält ein indexierter Chunk?
Ein Eintrag in teralune_corpus besteht nun aus mehreren zusammengehörigen Informationen:
Chunk
├── ID
├── Dokumenttext
├── Embedding
└── Metadaten
├── document_id
├── chunk_number
├── source
├── headings
├── version
├── language
├── access
├── status
├── authority
└── document_type
Damit können wir zwei unterschiedliche Arten von Abfragen kombinieren.
Die Embeddings ermöglichen die semantische Suche nach inhaltlich ähnlichen Chunks.
Die Metadaten erlauben es uns, den Suchraum anhand expliziter Eigenschaften wie Produktversion, Dokumentstatus oder Zugriffsklasse einzuschränken.
Beide Informationsarten ergänzen sich, erfüllen aber unterschiedliche Aufgaben.
Vollständige und inkrementelle Indexierung
Unser aktuelles Skript verarbeitet bei jedem Start sämtliche Markdown-Dokumente und erzeugt alle 115 Embeddings erneut.
Dank upsert() entstehen dabei keine zusätzlichen Einträge mit denselben IDs. Die erneute Embedding-Berechnung wird dadurch jedoch nicht verhindert.
Für eine produktive Ingestion-Pipeline wäre dieses Vorgehen auf Dauer ineffizient.
Eine weiterentwickelte Implementierung würde erkennen, welche Dokumente neu hinzugekommen sind, welche sich verändert haben und welche entfernt wurden.
Nur neue oder veränderte Inhalte müssten dann erneut eingebettet werden. Nicht mehr vorhandene Chunks müssten aus dem Index entfernt werden.
Für unser Lernziel verzichten wir zunächst auf diese zusätzliche Komplexität.
Wir möchten einen vollständigen, reproduzierbaren Indexierungslauf verstehen und anschließend mit einem persistenten Datenbestand arbeiten.
Was wir erreicht haben
Mit diesem Experiment haben wir erstmals einen größeren Teil unseres Teralune-Corpus in einer persistenten Vektordatenbank indexiert.
Die Collection teralune_corpus enthält jetzt 115 Chunks aus 36 Markdown-Dokumenten, einschließlich ihrer Embeddings und fachlichen Metadaten.
Diese Collection ist die Grundlage für die folgenden Experimente. Solange wir sie nicht verändern oder löschen, müssen wir die Dokumente für die Suche nicht erneut verarbeiten.
Im nächsten Abschnitt untersuchen wir, wie sich Dense Retrieval in diesem größeren Dokumentbestand verhält und warum semantisch ähnliche Treffer nicht automatisch die fachlich richtigen Ergebnisse sind.
3.10 Dense Retrieval unter realistischen Bedingungen
Mit unserer Collection teralune_corpus haben wir jetzt 115 Chunks aus 36 Markdown-Dokumenten indexiert.
Damit wird die semantische Suche interessanter.
Bei unseren ersten Experimenten mit nur acht Chunks war die Auswahl möglicher Treffer überschaubar. Jetzt enthält die Collection unterschiedliche Themen, Produktversionen, Dokumenttypen und Zugriffsklassen.
Die Vektorsuche muss aus diesem größeren Bestand diejenigen Chunks auswählen, deren Embeddings der jeweiligen Benutzerfrage am nächsten liegen.
Dabei werden wir feststellen, dass semantische Ähnlichkeit nicht automatisch fachliche Gültigkeit bedeutet.
Experiment 3.07: Vier Fragen an unseren Corpus
Wir verwenden das Skript 07_vector_search_corpus.py.
Voraussetzung ist, dass die Indexierung aus Abschnitt 3.9 erfolgreich abgeschlossen wurde und die Collection teralune_corpus existiert.
Starte das Experiment:
Unser Programm stellt vier Fragen:
QUESTIONS: list[str] = [
"How long does a cursor remain valid?",
"What happens when webhook delivery fails?",
"How long is an Orbit 3 access token valid?",
"How long does Orbit retain telemetry data?",
]
Die vier Query-Embeddings werden gemeinsam mit einem API-Aufruf erzeugt.
Anschließend durchsuchen wir Chroma für jede Frage einzeln:
for question, query_embedding in zip(
QUESTIONS,
query_embeddings,
):
results = collection.query(
    query_embeddings=[query_embedding],
    n_results=TOP_K,
)
Wir verwenden weiterhin TOP_K = 3.
Anders als beim Indexierungslauf werden keine Dokumente eingelesen und keine Dokument-Embeddings neu berechnet.
Das Programm verwendet ausschließlich die gespeicherte Collection und die vier neuen Query-Embeddings.
Fall 1: Die Cursor-Frage
Unsere erste Frage lautet:
Die Suche liefert:
1. D022-chunk-2 | distance=0.5347 | version=3.0 | status=current
   Pagination and cursors > Cursor traversal > Cursor validity

2. D022-chunk-1 | distance=0.9571 | version=3.0 | status=current
   Pagination and cursors > Cursor traversal

3. D022-chunk-4 | distance=1.0812 | version=3.0 | status=current
   Pagination and cursors > Recover an interrupted traversal
Der beste Treffer ist D022-chunk-2.
Dieser Chunk beschreibt ausdrücklich die Gültigkeitsdauer eines Cursors. Wie wir bereits in Abschnitt 3.6 gesehen haben, läuft ein Cursor nach 15 Minuten ab.
Auch die weiteren Treffer stammen aus dem passenden Dokument D022.
Für diese Frage funktioniert Dense Retrieval sehr gut: Der unmittelbar relevante Abschnitt steht auf Rang 1.
Fall 2: Fehlgeschlagene Webhook-Zustellung
Die zweite Frage lautet:
Die drei besten Treffer sind:
| Rang | Chunk | Distance | Abschnitt |
|---|---|---|---|
| 1 | D003-chunk-1 |
0.6411 | Acceptance and deadline |
| 2 | D003-chunk-5 |
0.7776 | Reconcile a connection failure |
| 3 | D003-chunk-2 |
0.9311 | Signing and scheduling |
Alle drei Chunks stammen aus dem Dokument D003 (Webhook Delivery Contract).
Die Treffer behandeln unterschiedliche Aspekte der Webhook-Zustellung. Insbesondere der zweite Treffer bezieht sich auf die Behandlung eines Verbindungsfehlers.
Das Ergebnis zeigt eine wichtige Eigenschaft von Dense Retrieval: Die Suche ist nicht darauf angewiesen, dass Benutzerfrage und Dokumentüberschrift exakt dieselben Wörter enthalten.
Sie kann auch inhaltlich verwandte Formulierungen zusammenführen.
Ob die drei gefundenen Chunks bereits ausreichen, um die Frage vollständig zu beantworten, lässt sich aus ihrer Rangfolge allein allerdings nicht ableiten.
Fall 3: Die falsche Produktversion gewinnt
Unsere dritte Frage ist besonders interessant:
Hier liefert Chroma folgende Ergebnisse:
1. D004-chunk-2 | distance=0.6811 | version=2.4 | status=historical
   Webhook Delivery in Orbit 2.4 > Legacy service accounts

2. D033-chunk-1 | distance=0.7536 | version=3.0 | status=current
   Orbit 3 release notes > Orbit 3.0 release

3. D002-chunk-1 | distance=0.7755 | version=3.0 | status=current
   OAuth and API Keys > Machine credentials
Der semantisch nächste Treffer stammt aus Orbit 2.4.
Die Benutzerfrage verlangt jedoch ausdrücklich Informationen zu Orbit 3.
Damit haben wir ein Problem.
Der erste Treffer besitzt zwar die geringste Distanz zum Query-Embedding, gehört aber zu einer historischen Produktversion.
Die beiden folgenden Treffer stammen dagegen aus der aktuellen Version 3.0.
Warum steht trotzdem das historische Dokument auf Rang 1?
Die Vektorsuche bewertet die Ähnlichkeit zwischen dem Query-Vektor und den gespeicherten Dokumentvektoren.
Das historische Dokument D004 enthält einen Abschnitt über Legacy service accounts. Sein Embedding liegt offenbar näher an unserer Frage nach der Gültigkeitsdauer eines Access Tokens als die Embeddings der beiden aktuellen Dokumente.
Chroma hat bei dieser ungefilterten Suche die Felder version und status nicht als Einschränkungen berücksichtigt.
Die Informationen waren zwar in den Metadaten vorhanden, wurden aber lediglich mit den Treffern ausgegeben.
Das ist kein Fehler der Distanzberechnung. Es ist eine fehlende fachliche Einschränkung unserer Suche.
Die Vektorsuche beantwortet:
Welche gespeicherten Vektoren liegen dem Query-Vektor am nächsten?
Unsere Anwendung benötigt jedoch eine Antwort auf eine andere Frage:
Welche fachlich gültigen Dokumente enthalten die Informationen, die zur Benutzerfrage passen?
Diese beiden Fragen sind nicht identisch.
Semantisch ähnlich bedeutet nicht fachlich gültig
Ein Dokument kann hervorragend zur Formulierung einer Benutzerfrage passen und trotzdem für die konkrete Anwendung ungeeignet sein.
Gründe dafür können beispielsweise eine veraltete Produktversion, ein ungültiger Dokumentstatus oder eine unzureichende Vertrauenswürdigkeit der Quelle sein.
Die semantische Ähnlichkeit allein kann solche Eigenschaften nicht zuverlässig beurteilen.
Fall 4: Telemetriedaten und historische Treffer
Unsere vierte Frage lautet:
Die Suche liefert:
| Rang | Chunk | Distance | Version | Status |
|---|---|---|---|---|
| 1 | D001-chunk-3 |
0.9018 | 3.0 | current |
| 2 | D033-chunk-1 |
1.0036 | 3.0 | current |
| 3 | D004-chunk-2 |
1.0261 | 2.4 | historical |
Auch hier erscheint ein historisches Dokument unter den ersten drei Treffern.
Diesmal liegt es nur auf Rang 3. Trotzdem könnte es in einem nachgelagerten RAG-Schritt als Kontext an das Sprachmodell übergeben werden.
Genau darin besteht das Risiko.
Ein Sprachmodell erhält beim klassischen RAG zunächst die gefundenen Textabschnitte. Wenn darunter veraltete oder widersprüchliche Informationen sind, muss es selbst entscheiden, welchen Aussagen es vertrauen soll.
Das ist unnötig riskant, wenn wir bereits anhand der Metadaten erkennen können, welche Dokumente für die Anfrage zulässig sind.
Wir sollten solche Entscheidungen deshalb möglichst vor der Übergabe an das Sprachmodell treffen.
Warum ein größerer Corpus anspruchsvoller ist
Unsere vier Testfragen zeigen unterschiedliche Ergebnisse.
Bei der Cursor-Frage steht der unmittelbar relevante Abschnitt auf Rang 1. Auch die Webhook-Frage führt zu thematisch passenden Dokumentabschnitten.
Bei der Frage nach Orbit-3-Access-Tokens gewinnt dagegen ein historisches Dokument.
Die Telemetrie-Frage zeigt ebenfalls, dass historische Inhalte unter den besten Treffern erscheinen können.
Das verdeutlicht eine grundlegende Grenze von Dense Retrieval:
Die Vektorsuche optimiert die Rangfolge nach semantischer Nähe, nicht nach sämtlichen fachlichen Regeln unserer Anwendung.
Je vielfältiger ein Dokumentbestand wird, desto wichtiger werden zusätzliche Einschränkungen.
Dazu gehören beispielsweise:
- Produktversion: Welche Version ist für die Anfrage relevant?
- Dokumentstatus: Sind historische Dokumente erlaubt?
- Quellenautorität: Welche Quellen gelten als maßgeblich?
- Zugriffsrechte: Welche Inhalte darf der Benutzer überhaupt erhalten?
Einige dieser Bedingungen lassen sich mit den Metadatenfiltern umsetzen, die wir bereits in Abschnitt 3.7 kennengelernt haben.
Andere erfordern zusätzliche Anwendungslogik, insbesondere bei der Zugriffskontrolle.
Was wir aus dem Experiment lernen
Unsere Collection enthält bereits die notwendigen Metadaten, um aktuelle und historische Dokumente zu unterscheiden.
Wir haben sie bei den bisherigen Suchanfragen jedoch noch nicht zur Einschränkung des Suchraums verwendet.
Das ändern wir im nächsten Abschnitt.
Dort kombinieren wir zwei Bedingungen: Ein Dokument muss zur Produktversion 3.0 gehören und den Status current besitzen.
Damit untersuchen wir, wie sich die Trefferliste verändert, wenn wir fachlich unzulässige Dokumente bereits beim Retrieval ausschließen.
3.11 Versionen und Status filtern
Im vorherigen Experiment haben wir eine Schwäche unserer ungefilterten Vektorsuche entdeckt.
Auf die Frage nach der Gültigkeitsdauer eines Orbit-3-Access-Tokens lieferte Chroma ausgerechnet einen Abschnitt aus der historischen Produktversion 2.4 als besten Treffer.
Das Embedding dieses Abschnitts lag dem Query-Embedding am nächsten. Fachlich war das Dokument für unsere Anfrage jedoch nicht die richtige Wahl.
Dabei besitzen wir bereits die Informationen, um dieses Problem zu vermeiden.
Unser Dokumentmanifest enthält für jeden Chunk unter anderem die Produktversion und den Dokumentstatus. Beide Eigenschaften haben wir bei der Indexierung als Metadaten in Chroma gespeichert.
Jetzt verwenden wir sie, um den Suchraum gezielt einzuschränken.
Zwei Bedingungen für gültige Dokumente
Unsere Benutzerfrage lautet erneut:
Die Frage enthält bereits eine wichtige Information: Gesucht werden Angaben zur Produktversion Orbit 3.
Für unser Experiment legen wir deshalb zwei Bedingungen fest:
- Die Dokumentversion muss
3.0sein. - Der Dokumentstatus muss
currentsein.
Nur Chunks, die beide Bedingungen erfüllen, sollen an der Suche teilnehmen.
In unserem Beispiel ergibt sich die Produktversion direkt aus der Benutzerfrage („Orbit 3“); in einer realen Anwendung könnten solche Filterwerte auch aus dem aktuellen Anwendungskontext, einer Produktauswahl oder den Benutzerberechtigungen stammen. Der Status
currentergibt sich dagegen aus unserer fachlichen Vorgabe, nur aktuelle Dokumente zu berücksichtigen.
Damit ist klar, woher die Filterwerte kommen und wer die Regeln festlegt.
In Chroma können wir solche Bedingungen mit dem Parameter where formulieren:
Der Operator $and verknüpft die beiden Bedingungen logisch.
Ein Chunk ist nur dann zulässig, wenn seine Metadaten sowohl version = 3.0 als auch status = current enthalten.
Damit treffen wir eine fachliche Entscheidung, bevor wir die semantischen Treffer bewerten.
Experiment 3.08: Ungefilterte und gefilterte Suche vergleichen
Für dieses Experiment verwenden wir weiterhin die Collection teralune_corpus aus Abschnitt 3.9.
Starte das Programm:
Das Skript erzeugt zunächst ein einziges Query-Embedding:
Anschließend führt es zwei Suchvorgänge mit demselben Embedding aus.
Zuerst suchen wir ohne Einschränkungen:
Danach verwenden wir unseren Metadatenfilter:
filtered_results = collection.query(
query_embeddings=[query_embedding],
n_results=TOP_K,
where={
    "$and": [
        {"version": "3.0"},
        {"status": "current"},
    ]
},
)
Diesmal verwenden wir TOP_K = 5, damit wir die Veränderungen in der Trefferliste besser erkennen können.
Die ungefilterte Suche
Unser Laborlauf liefert zunächst folgende Ergebnisse:
Unfiltered search:
1. D004-chunk-2 | distance=0.6802 | version=2.4 | status=historical
2. D033-chunk-1 | distance=0.7544 | version=3.0 | status=current
3. D002-chunk-1 | distance=0.7751 | version=3.0 | status=current
4. D005-chunk-1 | distance=0.9018 | version=3.0 | status=current
5. D016-chunk-1 | distance=0.9204 | version=1.8 | status=historical
Wie im vorherigen Experiment steht D004-chunk-2 auf Rang 1.
Dieser Chunk stammt aus dem historischen Dokument Webhook Delivery in Orbit 2.4.
Auch auf Rang 5 erscheint mit D016-chunk-1 ein historischer Abschnitt, diesmal aus der Produktversion 1.8.
Obwohl unsere Frage ausdrücklich Orbit 3 betrifft, befinden sich also zwei historische Dokumente unter den fünf besten Treffern.
Die Metadaten zeigen uns das Problem bereits an. Bislang haben wir sie aber noch nicht zur Einschränkung der Suche verwendet.
Die gefilterte Suche
Mit unserem Filter verändert sich die Trefferliste:
Filtered to version 3.0 and status current:
1. D033-chunk-1 | distance=0.7544 | version=3.0 | status=current
2. D002-chunk-1 | distance=0.7751 | version=3.0 | status=current
3. D005-chunk-1 | distance=0.9018 | version=3.0 | status=current
4. D002-chunk-2 | distance=0.9902 | version=3.0 | status=current
5. D001-chunk-3 | distance=0.9939 | version=3.0 | status=current
Die beiden historischen Chunks D004-chunk-2 und D016-chunk-1 sind verschwunden.
Stattdessen erhalten wir ausschließlich Chunks aus Dokumenten der Version 3.0 mit dem Status current.
Die Ergebnisse lassen sich direkt vergleichen:
| Chunk | Ohne Filter | Mit Filter | Veränderung |
|---|---|---|---|
D004-chunk-2 |
Rang 1 | ausgeschlossen | Historische Version 2.4 |
D033-chunk-1 |
Rang 2 | Rang 1 | Weiterhin zulässig |
D002-chunk-1 |
Rang 3 | Rang 2 | Weiterhin zulässig |
D005-chunk-1 |
Rang 4 | Rang 3 | Weiterhin zulässig |
D016-chunk-1 |
Rang 5 | ausgeschlossen | Historische Version 1.8 |
Der Filter hat damit genau das erreicht, was wir beabsichtigt haben: Historische Dokumente werden bei dieser Suche nicht mehr berücksichtigt.
Warum verändern sich die Distanzen nicht?
Betrachten wir die beiden besten verbleibenden Treffer:
| Chunk | Distance ohne Filter | Distance mit Filter |
|---|---|---|
D033-chunk-1 |
0.7544 | 0.7544 |
D002-chunk-1 |
0.7751 | 0.7751 |
Die Distanzen sind identisch geblieben.
Das ist eine wichtige Beobachtung.
Wir haben weder das Query-Embedding noch die gespeicherten Dokument-Embeddings verändert. Auch die Distanzmetrik ist unverändert.
Der Filter bestimmt lediglich, welche Chunks für die Suche zulässig sind.
Die folgende Grafik veranschaulicht diesen Zusammenhang:
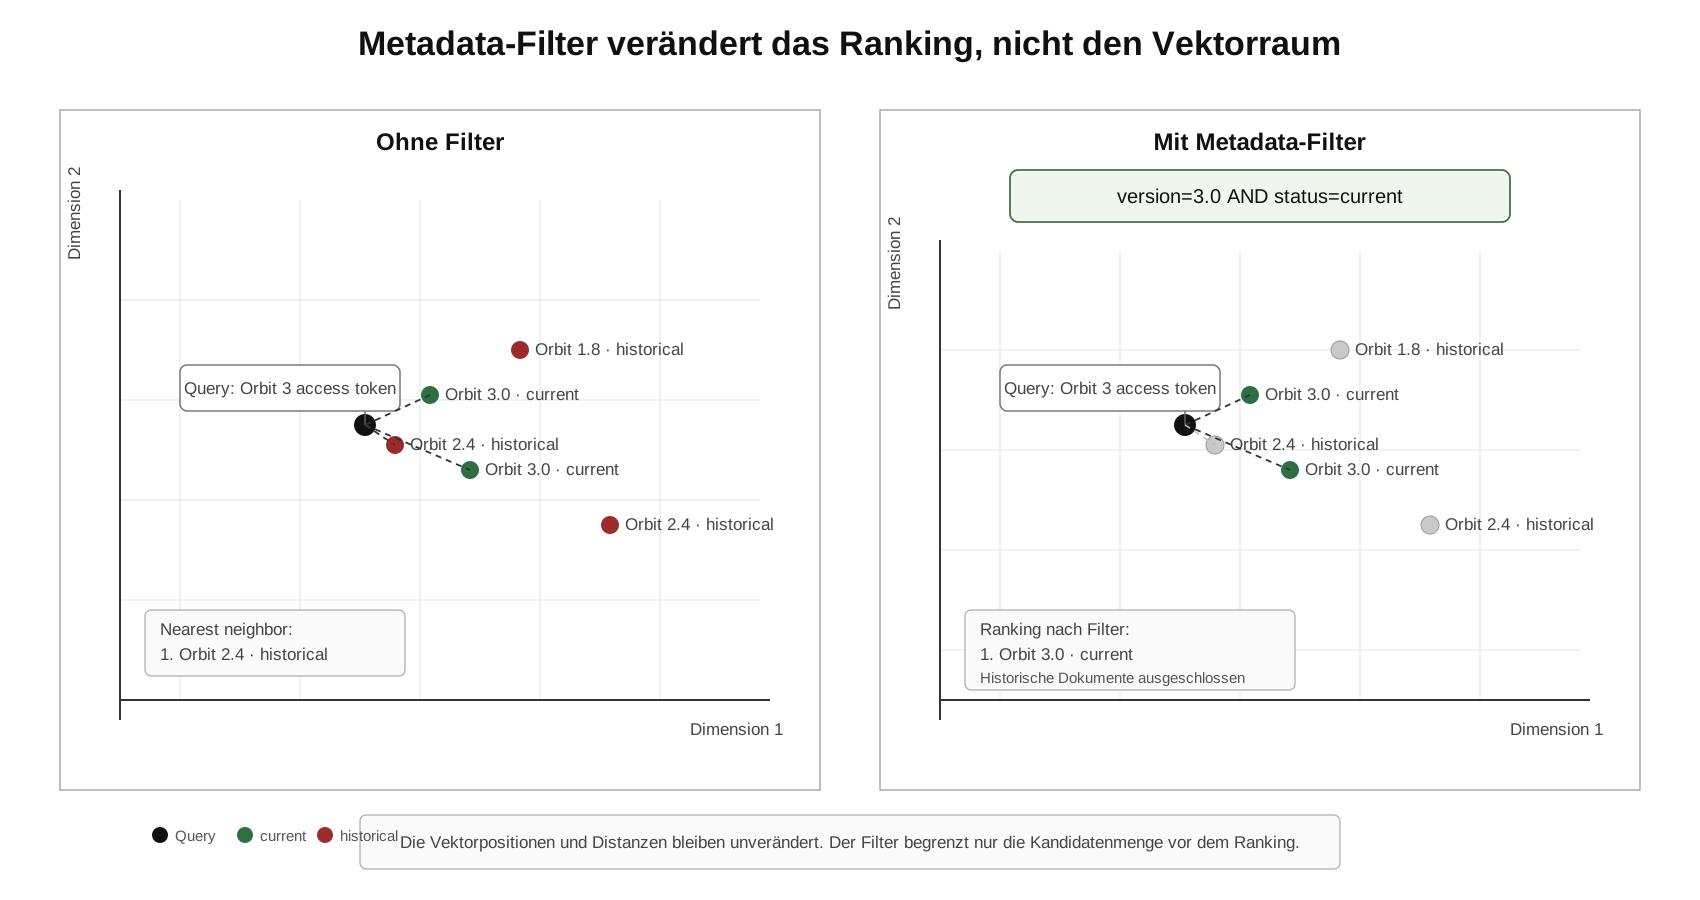
Die Vektoren behalten ihre Positionen im Embedding-Raum. Der Metadatenfilter schließt bestimmte Kandidaten aus, ohne ihre semantischen Beziehungen zu verändern.
Filtern und Ranking sind unterschiedliche Aufgaben
Metadata Filtering definiert, welche Kandidaten für eine Suche zulässig sind.
Vector Search bestimmt anhand der Vektordistanzen die Rangfolge dieser Kandidaten.
Diese Trennung ist ein wichtiger Architekturgrundsatz: Fachliche Regeln wie Produktversionen oder Dokumentstatus sollten nicht allein einem Embedding-Modell oder einem Sprachmodell überlassen werden.
Der Filter löst nicht alle Retrieval-Probleme
Unser Experiment hat die historischen Dokumente erfolgreich ausgeschlossen.
Trotzdem bleibt ein interessantes Problem bestehen.
Nach dem Filtern steht D033-chunk-1 weiterhin auf Rang 1. Dieser Chunk stammt aus den Orbit 3 release notes.
Erst auf Rang 2 folgt D002-chunk-1 aus dem Dokument OAuth and API Keys, Abschnitt Machine credentials.
Für unsere konkrete Frage nach der Gültigkeitsdauer eines Access Tokens ist D002 die präzisere fachliche Quelle.
Die Vektorsuche bevorzugt jedoch weiterhin D033.
Warum?
Weil der Filter ausschließlich die Zulässigkeit der Kandidaten bestimmt. Er bewertet nicht, welches Dokument innerhalb der zulässigen Menge die fachlich beste Antwortquelle ist.
Auch das Feld authority könnte hier nicht ohne Weiteres helfen. Beide Dokumente besitzen in unserem Corpus den Wert official.
Wir benötigen also zusätzliche Verfahren, wenn wir die Rangfolge der zulässigen Treffer weiter verbessern möchten.
Dazu gehören beispielsweise die Kombination von Dense Retrieval mit einer klassischen Stichwortsuche oder ein nachgelagertes Reranking.
Diese Verfahren behandeln wir in Kapitel 4.
Was wir erreicht haben
Mit diesem Experiment haben wir gezeigt, wie sich fachliche Bedingungen direkt in eine Vektorsuche integrieren lassen.
Unsere Query wurde nicht verändert. Auch die Embeddings blieben identisch.
Trotzdem erhielten wir eine deutlich besser geeignete Trefferliste, weil historische Dokumente nicht mehr als Kandidaten zugelassen wurden.
Metadatenfilter sorgen für einen fachlich zulässigen Suchraum. Sie garantieren jedoch noch keine optimale Rangfolge innerhalb dieses Suchraums.
Damit verfügen wir über die wesentlichen Bausteine, um unsere persistente Chroma-Collection in einer vollständigen RAG-Pipeline einzusetzen.
Im nächsten Abschnitt verbinden wir die Vektorsuche mit einem Sprachmodell, das aus den gefundenen Dokumentabschnitten eine Antwort formuliert.
3.12 RAG mit einem persistenten Vector Store
Wir besitzen jetzt alle wesentlichen Bausteine für eine vollständige RAG-Pipeline mit einer persistenten Vektordatenbank.
In den bisherigen Experimenten haben wir Dokumente verarbeitet, strukturorientierte Chunks erzeugt, Embeddings berechnet und diese zusammen mit den Dokumentmetadaten in Chroma gespeichert.
Anschließend haben wir gelernt, wie wir die gespeicherten Chunks semantisch durchsuchen und den Suchraum mithilfe von Metadatenfiltern einschränken können.
Jetzt verbinden wir diese Komponenten wieder mit einem Sprachmodell.
Das Ergebnis ist ein RAG-System, bei dem die Dokumentverarbeitung vollständig von der Beantwortung der Benutzerfragen getrennt ist.
Eine vollständige RAG-Pipeline
Unser letztes Programm dieses Kapitels verwendet die Collection teralune_corpus, die wir in Abschnitt 3.9 erstellt haben.
Das Skript benötigt weder den ursprünglichen Corpus-Pfad noch einen Markdown-Parser oder Chunker.
Die Dokumentverarbeitung ist bereits abgeschlossen.
Für eine neue Benutzerfrage führt das Programm nur noch folgende Schritte aus:
- Es erzeugt ein Embedding für die Benutzerfrage.
- Es durchsucht Chroma unter Berücksichtigung der Metadatenfilter.
- Es übernimmt die gefundenen Chunks in einen Kontext.
- Es übergibt Frage und Kontext an ein Sprachmodell.
- Es gibt die generierte Antwort aus.
Unsere Gesamtarchitektur sieht damit folgendermaßen aus:
flowchart TB
    subgraph ING["Ingestion: bei Aufnahme oder Änderung"]
        direction LR
        A["Dokumente"] --> B["Parsing"]
        B --> C["Chunking"]
        C --> D["Dokument-Embeddings"]
        M["Dokumentmanifest"] --> N["Metadaten"]
        D --> E[("Chroma")]
        N --> E
    end

    subgraph QUERY["Query: bei jeder Benutzerfrage"]
        direction LR
        F["Benutzerfrage"] --> G["Query-Embedding"]
        G --> H["Vektorsuche mit Metadatenfilter"]
        H --> I["Top-k Chunks"]
        I --> J["Kontext"]
        J --> K["LLM"]
        K --> L["Antwort"]
    end

    E --> H

    classDef input fill:#DBEAFE,stroke:#2563EB,color:#1E40AF
    classDef processing fill:#DCFCE7,stroke:#16A34A,color:#166534
    classDef retrieval fill:#FFEDD5,stroke:#EA580C,color:#9A3412
    classDef infrastructure fill:#F3F4F6,stroke:#6B7280,color:#374151
    classDef generation fill:#EDE9FE,stroke:#7C3AED,color:#5B21B6

    class A,M,F input
    class B,C,D,N,G processing
    class H,I,J retrieval
    class E infrastructure
    class K,L generation

    style ING fill:#F0FDF4,stroke:#86EFAC,color:#166534
    style QUERY fill:#FFF7ED,stroke:#FDBA74,color:#9A3412
Die beiden Verarbeitungspfade greifen auf dieselbe Chroma-Collection zu, werden aber unabhängig voneinander ausgeführt.
Die Ingestion aktualisiert den Wissensbestand. Die Query-Pipeline verwendet diesen Bestand, um Benutzerfragen zu beantworten.
Experiment 3.09: RAG mit Chroma
Für unser abschließendes Experiment benötigen wir die bereits indexierte Collection teralune_corpus und einen konfigurierten OpenAI-API-Schlüssel.
Falls die Collection noch nicht existiert, muss zunächst das Indexierungsskript aus Abschnitt 3.9 ausgeführt werden.
Starte anschließend das RAG-Programm:
Wir verwenden erneut unsere bekannte Frage:
Das Programm erzeugt zunächst das Query-Embedding mit text-embedding-3-small.
Anschließend durchsuchen wir Chroma und beschränken die Suche auf aktuelle Dokumente der Version 3.0:
results = collection.query(
    query_embeddings=[query_embedding],
    n_results=TOP_K,
    where={
        "$and": [
            {"version": "3.0"},
            {"status": "current"},
        ]
    },
)
Der Filter entspricht dem aus Abschnitt 3.11.
Auch hier sind die Werte 3.0 und current bewusst für unser Experiment festgelegt. In einer realen Anwendung würden solche Bedingungen aus der Benutzerfrage, dem Anwendungskontext und den geltenden fachlichen Regeln abgeleitet.
Die gefundenen Dokumentabschnitte
Unser Laborlauf liefert folgende Treffer:
Retrieved chunks:
1. D033-chunk-1 | distance=0.7544 | Orbit 3 release notes > Orbit 3.0 release
2. D002-chunk-1 | distance=0.7751 | OAuth and API Keys > Machine credentials
3. D005-chunk-1 | distance=0.9018 | Migrating from Orbit 2.4 to 3.0 > Contract changes
Alle drei Chunks stammen aus aktuellen Dokumenten der Version 3.0.
Wie bereits im vorherigen Experiment steht der Abschnitt aus den Release Notes auf Rang 1. Die für unsere Frage besonders relevante Quelle D002-chunk-1 folgt auf Rang 2.
Das ist für unser Experiment ausreichend, weil wir alle drei Treffer an das Sprachmodell weitergeben.
Wir müssen jedoch im Hinterkopf behalten, dass die Reihenfolge nicht zwangsläufig der fachlichen Qualität der Quellen entspricht.
Aus Retrieval-Ergebnissen wird ein Kontext
Die gefundenen Chunks liegen zunächst als strukturierte Chroma-Ergebnisse vor.
Unser Sprachmodell benötigt daraus eine Textrepräsentation.
Dafür verwenden wir die Funktion build_context().
Sie übernimmt für jeden Treffer die Chunk-ID, die Dokument-ID, die Produktversion, den Überschriftenpfad und den eigentlichen Text.
Ein einzelner Kontexteintrag besitzt damit folgende Struktur:
Chunk: D002-chunk-1
Document: D002
Version: 3.0
Section: OAuth and API Keys > Machine credentials

[Chunk text]
Die einzelnen Einträge werden durch eine Trennlinie voneinander abgegrenzt.
Im Python-Code geschieht das mit:
Dadurch entsteht ein zusammenhängender Kontext, der mehrere Dokumentabschnitte enthält und zugleich ihre Herkunft erkennen lässt.
Diese Struktur ist hilfreich, weil das Sprachmodell nicht nur den Inhalt erhält, sondern auch Informationen darüber, aus welchem Dokument und Abschnitt die jeweilige Aussage stammt.
Die Chunk-IDs könnten wir später außerdem verwenden, um Quellenverweise in die generierte Antwort aufzunehmen.
Unser aktuelles Experiment gibt solche Quellenverweise allerdings noch nicht aus.
Die Antwort mit dem Sprachmodell erzeugen
Jetzt übergeben wir die Benutzerfrage und den zusammengestellten Kontext an das Sprachmodell.
Wir verwenden dafür die OpenAI Responses API mit gpt-4.1-mini.
Die Funktion answer_question() enthält folgende Anweisung:
instructions=(
    "Answer the question using only the provided context. "
    "If the context does not contain enough information, "
    "say that the question cannot be answered from the "
    "provided context. Do not use outside knowledge."
)
Das Modell soll seine Antwort ausschließlich aus den gefundenen Dokumentabschnitten ableiten.
Falls der Kontext keine ausreichenden Informationen enthält, soll es dies ausdrücklich mitteilen.
Die eigentliche Anfrage setzt sich aus der Benutzerfrage und dem Retrieval-Kontext zusammen:
Damit verwenden wir dieselbe grundlegende RAG-Idee wie in Kapitel 1: Wir ergänzen die Anfrage an das Sprachmodell um relevante externe Informationen.
Der Unterschied liegt darin, wie wir diese Informationen bereitstellen.
Kontextbindung ist keine Garantie
Die Anweisung, ausschließlich den bereitgestellten Kontext zu verwenden, reduziert das Risiko unbelegter Antworten. Sie garantiert jedoch nicht, dass das Sprachmodell diese Vorgabe immer einhält.
Ein Modell kann Informationen falsch interpretieren, Aussagen aus unterschiedlichen Quellen vermischen oder trotz unzureichender Evidenz eine Antwort formulieren.
Ob eine Antwort tatsächlich durch die gefundenen Quellen gestützt wird, müssen wir deshalb gesondert überprüfen.
Mit solchen Qualitätsfragen beschäftigen wir uns später bei der Evaluation von RAG-Systemen.
Das Ergebnis
Unser vollständiger Laborlauf endet mit folgender Ausgabe:
Question: How long is an Orbit 3 access token valid?

Retrieved chunks:
1. D033-chunk-1 | distance=0.7544 | Orbit 3 release notes > Orbit 3.0 release
2. D002-chunk-1 | distance=0.7751 | OAuth and API Keys > Machine credentials
3. D005-chunk-1 | distance=0.9018 | Migrating from Orbit 2.4 to 3.0 > Contract changes

Answer:
An Orbit 3 access token is valid for 60 minutes.
Das Sprachmodell beantwortet unsere Frage korrekt:
Ein Orbit-3-Access-Token ist 60 Minuten gültig.
Die Information stammt aus dem zuvor indexierten Dokumentbestand.
Während der Anfrage mussten wir weder die Markdown-Dokumente erneut laden noch die 115 Dokument-Embeddings neu berechnen.
Wir haben lediglich ein neues Query-Embedding erzeugt, drei Chunks aus Chroma abgerufen und diese an das Sprachmodell übergeben.
Was hat sich gegenüber unserem ersten RAG-Experiment verändert?
Erinnern wir uns an unser erstes RAG-Programm aus Kapitel 1.
Damals verwendeten wir eine kleine Liste von Textabschnitten direkt im Python-Code. Bei jedem Programmstart erzeugten wir ihre Embeddings, verglichen sie mit dem Query-Embedding und übergaben die besten Treffer an das Sprachmodell.
Das war ein sinnvoller Einstieg, aber noch keine Architektur für einen größeren Dokumentbestand.
Inzwischen haben wir mehrere wichtige Verbesserungen umgesetzt:
| Kapitel 1 | Unser aktuelles RAG-System |
|---|---|
| Wenige fest codierte Textabschnitte | 115 Chunks aus 36 Markdown-Dokumenten |
| Embeddings bei jedem Programmstart | Persistente Dokument-Embeddings in Chroma |
| Dokumente und Suche im selben Programm | Getrennte Ingestion- und Query-Pipeline |
| Reine semantische Suche | Semantische Suche mit Metadatenfiltern |
| Keine dokumentbezogenen Gültigkeitsregeln | Filter für Produktversion und Dokumentstatus |
| Einfache Textliste | Strukturierte Chunks mit Herkunftsinformationen |
Der entscheidende Fortschritt ist die persistente Retrieval-Schicht.
Wir können unseren Dokumentbestand unabhängig von den Benutzeranfragen aufbereiten und speichern. Anschließend können beliebig viele Anfragen auf denselben Index zugreifen, ohne die Dokumentverarbeitung jedes Mal zu wiederholen.
Was wir erreicht haben
Mit diesem Experiment haben wir eine vollständige RAG-Pipeline auf Basis eines persistenten Vector Stores aufgebaut.
Sie verbindet Dokumentverarbeitung, Embeddings, Chroma, Metadatenfilter und ein Sprachmodell.
Dabei haben wir die beiden zentralen Verarbeitungspfade voneinander getrennt:
Ingestion: Dokumente werden aufgenommen, verarbeitet und indexiert.
Query: Benutzerfragen werden eingebettet, passende Chunks abgerufen und daraus Antworten generiert.
Damit verfügen wir über eine solide Grundlage für weitere Verbesserungen.
Unsere bisherigen Experimente haben allerdings auch gezeigt, dass eine Vektordatenbank allein noch keine optimale Retrieval-Qualität garantiert.
Im abschließenden Abschnitt betrachten wir deshalb die Grenzen unserer bisherigen Lösung und bereiten den Übergang zu den erweiterten Retrieval-Verfahren des nächsten Kapitels vor.
3.13 Was Vector Search noch nicht löst
Unser RAG-System hat sich in den ersten drei Kapiteln erheblich weiterentwickelt.
Wir können inzwischen Dokumente aus unterschiedlichen Dateiformaten einlesen, ihre Struktur beim Chunking berücksichtigen und die erzeugten Chunks mit stabilen IDs und Metadaten versehen.
Außerdem haben wir eine persistente Vektordatenbank aufgebaut. Sie speichert unsere Dokumenttexte und Embeddings, ermöglicht semantische Suchanfragen und unterstützt Metadatenfilter.
Schließlich haben wir diese Komponenten mit einem Sprachmodell verbunden, sodass unser System aus den gefundenen Dokumentabschnitten eine Antwort generieren kann.
Damit besitzen wir eine funktionsfähige RAG-Pipeline.
Aber eine funktionierende Pipeline ist noch keine Garantie für gutes Retrieval.
Der beste Treffer ist nicht immer die beste Quelle
Unser letztes Experiment hat bereits eine interessante Schwäche gezeigt.
Für die Frage nach der Gültigkeitsdauer eines Orbit-3-Access-Tokens lieferte die Vektorsuche nach Anwendung des Versionsfilters folgende Rangfolge:
1. D033  Orbit 3 release notes
2. D002  OAuth and API Keys > Machine credentials
3. D005  Migrating from Orbit 2.4 to 3.0
Der Chunk aus D002 enthält die präzise Dokumentation der Machine Credentials und damit die direkte Antwort auf unsere Frage.
Trotzdem steht er nur auf Rang 2.
Für unser konkretes Experiment war das kein Problem. Mit top_k=3 haben wir alle drei Treffer an das Sprachmodell übergeben. Die benötigte Information war im Kontext enthalten, und das Modell konnte korrekt antworten:
Daraus dürfen wir allerdings nicht schließen, dass Dense Retrieval grundsätzlich ausreicht.
Hätten wir nur den besten Treffer verwendet, wäre die relevante Dokumentation möglicherweise nicht im Kontext gelandet.
Ein größeres top_k kann dieses Risiko reduzieren. Es bringt jedoch zusätzliche Texte in den Kontext, die nicht unbedingt zur Beantwortung der Frage beitragen.
Mehr Kontext bedeutet nicht automatisch bessere Antworten.
Wenn exakte Begriffe entscheidend sind
Bisher haben wir überwiegend natürlichsprachliche Fragen gestellt.
In technischen Dokumentationen suchen Benutzer jedoch häufig nach sehr konkreten Zeichenfolgen.
Beispielsweise nach einem Fehlercode:
Oder nach einem API-Endpunkt:
Auch Konfigurationsschlüssel, Klassennamen, Versionsnummern oder seltene Produktbezeichnungen können für eine Suche entscheidend sein.
Bei solchen Anfragen möchten wir Dokumente finden, die den gesuchten Ausdruck tatsächlich enthalten.
Dense Retrieval bewertet jedoch die Ähnlichkeit zwischen Vektoren. Eine exakte Zeichenfolge wird dabei nicht automatisch als zwingende Suchbedingung behandelt.
Ein Dokument kann semantisch gut zur Anfrage passen, obwohl es einen anderen Fehlercode oder einen ähnlichen API-Endpunkt beschreibt.
Gerade in technischen Anwendungen kann dieser Unterschied entscheidend sein.
Warum wir Dense Retrieval trotzdem benötigen
Die umgekehrte Situation ist genauso wichtig.
Ein Benutzer könnte fragen:
Was passiert, wenn ich eine paginierte Abfrage zu lange unterbreche?
Die Dokumentation beschreibt denselben Sachverhalt möglicherweise mit Begriffen wie cursor expiration, traversal und restart.
Eine rein lexikalische Suche kann Schwierigkeiten haben, solche unterschiedlichen Formulierungen miteinander zu verbinden.
Dense Retrieval ist gerade deshalb wertvoll, weil es semantische Zusammenhänge berücksichtigt und nicht ausschließlich auf identische Wörter angewiesen ist.
Wir haben es also mit zwei unterschiedlichen Stärken zu tun:
| Suchverfahren | Besondere Stärke |
|---|---|
| Dense Retrieval | Inhaltlich ähnliche Texte trotz unterschiedlicher Formulierungen finden |
| Lexikalisches Retrieval | Exakte Begriffe, seltene Schlüsselwörter und technische Bezeichner berücksichtigen |
Keines der beiden Verfahren ist für jede Suchanfrage automatisch überlegen.
Die Herausforderung besteht darin, ihre Stärken sinnvoll zu kombinieren.
Die nächste Entwicklungsstufe
In Kapitel 4 beschäftigen wir uns deshalb ausführlich mit der Qualität unserer Retrieval-Ergebnisse.
Wir untersuchen zunächst, wie Dense Retrieval arbeitet und welche Grenzen es besitzt.
Anschließend lernen wir mit BM25 ein lexikalisches Suchverfahren kennen, das die Bedeutung einzelner Suchbegriffe anhand statistischer Eigenschaften bewertet.
Danach kombinieren wir beide Ansätze zu Hybrid Search.
Mit Verfahren wie Reciprocal Rank Fusion (RRF) können wir unterschiedliche Trefferlisten zusammenführen. Durch Reranking lässt sich die Reihenfolge der gefundenen Kandidaten zusätzlich verbessern.
Unser Ziel ist dabei nicht, möglichst viele Dokumente abzurufen.
Wir möchten diejenigen Dokumentabschnitte finden, die für die konkrete Benutzerfrage tatsächlich relevant und fachlich geeignet sind.
Denn die Qualität einer RAG-Antwort hängt wesentlich davon ab, welche Informationen wir dem Sprachmodell bereitstellen.
Fazit
Mit Chroma haben wir eine persistente Retrieval-Schicht aufgebaut, die Dokumente und ihre Embeddings unabhängig von einzelnen Benutzeranfragen verwaltet.
Metadatenfilter ermöglichen uns, den Suchraum anhand fachlicher Regeln einzuschränken.
Die semantische Suche liefert anschließend Kandidaten, die inhaltlich zur Benutzerfrage passen.
Was uns noch fehlt, ist eine ausgereiftere Strategie, um diese Kandidaten zuverlässig auszuwählen und zu priorisieren.
Die Vektordatenbank ist deshalb nicht das Ende unserer Retrieval-Pipeline. Sie bildet die persistente Grundlage, auf der wir bessere Retrieval-Verfahren aufbauen.
Im nächsten Kapitel konzentrieren wir uns genau auf diese Aufgabe: aus einem vorhandenen Wissensbestand möglichst zuverlässig den richtigen Kontext für eine RAG-Antwort zu finden.