2 Dokumente einlesen und sinnvoll chunken
Im vorherigen Kapitel haben wir unser erstes vollständiges RAG-System entwickelt. Wir konnten Texte in Embeddings umwandeln, relevante Informationen anhand ihrer Ähnlichkeit zu einer Benutzerfrage finden und diese Informationen einem Sprachmodell zur Antwortgenerierung übergeben.
Unsere Wissensbasis bestand allerdings aus wenigen sorgfältig formulierten Sätzen. Jeder Satz enthielt eine klar abgegrenzte Information und war damit bereits eine nahezu perfekte Einheit für das Retrieval.
In realen Anwendungen bekommen wir solche Einheiten nicht fertig geliefert.
Stattdessen liegen Informationen in Markdown-Dateien, HTML-Seiten, Tabellen, Word-Dokumenten oder PDFs vor. Ein Dokument kann mehrere Themen behandeln, unterschiedliche Strukturen enthalten und seine Informationen über zahlreiche Abschnitte verteilen.
Bevor wir diese Inhalte für RAG verwenden können, müssen wir deshalb zwei grundlegende Fragen beantworten:
- Wie gewinnen wir Informationen aus unterschiedlichen Dokumentformaten?
- Wie zerlegen wir diese Informationen in geeignete Einheiten für das Retrieval?
Mit der zweiten Frage beschäftigen wir uns in diesem Kapitel besonders intensiv. Das Zerlegen längerer Texte in kleinere, durchsuchbare Einheiten bezeichnen wir als Chunking. Die entstehenden Textabschnitte heißen Chunks.
Dabei werden wir drei Strategien untersuchen: Fixed-Size-Chunking, Fixed-Size-Chunking mit Overlap und strukturorientiertes Chunking.
Wir werden feststellen, dass keine dieser Strategien automatisch die beste ist. Entscheidend ist nicht, wie ordentlich die Chunks aussehen, sondern ob unser Retriever später die Informationen findet, die zur Beantwortung einer Frage benötigt werden.
Am Ende des Kapitels bauen wir erneut ein vollständiges RAG-System. Diesmal verwenden wir keine vorbereiteten Beispielsätze, sondern Dokumente aus unserem Teralune-Corpus. Unser System muss eine Frage beantworten, für die Informationen aus zwei verschiedenen Dokumenten erforderlich sind.
Unser Praxisbeispiel: Der Teralune-Corpus
In den folgenden Kapiteln arbeiten wir mit einem durchgehenden Praxisbeispiel: Teralune, einem fiktiven Softwareunternehmen, das die Plattform Orbit entwickelt.
Orbit stellt unter anderem APIs für die Integration externer Anwendungen bereit. Die Plattform verwendet Zugriffstoken zur Authentifizierung, unterstützt Webhooks und bietet Funktionen zur Verarbeitung und zum Export von Daten.
Wie bei einer echten Softwareplattform entsteht dabei eine umfangreiche technische Dokumentation. Entwickler benötigen API-Referenzen, Administratoren suchen nach Betriebsanleitungen und bei neuen Produktversionen müssen Änderungen nachvollziehbar dokumentiert werden.
Für unser Buch haben wir deshalb den Teralune-Corpus zusammengestellt: eine synthetische Sammlung realistischer Unternehmensdokumente, die uns als gemeinsame Wissensbasis für unsere praktischen Experimente dient.
Der Corpus enthält unterschiedliche Dokumentarten und Dateiformate, darunter Markdown, HTML, PDF, DOCX und CSV. Neben API-Dokumentation und technischen Anleitungen finden sich beispielsweise Release Notes, Migrationshinweise und Betriebsinformationen.
Dabei sind die Dokumente bewusst nicht alle gleich aufgebaut. Manche enthalten längere Fließtexte, andere Tabellen oder strukturierte technische Angaben. Außerdem beschreibt der Corpus unterschiedliche Versionen von Orbit. Eine Information kann für eine ältere Version korrekt sein, für eine neuere Version aber nicht mehr gelten.
Genau solche Eigenschaften machen Unternehmenswissen für RAG interessant und gleichzeitig schwierig.
Warum ein fiktiver Corpus?
Wir verwenden Teralune, damit unsere Experimente reproduzierbar bleiben und wir gezielt typische Probleme realer RAG-Anwendungen untersuchen können.
Die Dokumente sind erfunden. Ihre Struktur und die darin angelegten Herausforderungen orientieren sich jedoch an realistischen Unternehmensszenarien. So können wir beispielsweise untersuchen, warum eine Suche veraltete Informationen findet oder weshalb ein Dokument trotz passender Begriffe nicht die richtige Antwort enthält.
Der wichtigste Vorteil ist, dass wir nicht für jedes Kapitel neue Beispieldaten benötigen. Stattdessen begleiten wir dieselbe Wissensbasis durch die verschiedenen Verarbeitungsschritte eines RAG-Systems.
In diesem Kapitel beginnen wir mit dem Einlesen und Aufbereiten der Dokumente. Anschließend zerlegen wir ihre Inhalte in geeignete Textabschnitte und untersuchen, wie sich unterschiedliche Chunking-Strategien auf das Retrieval auswirken.
Später werden wir diese Chunks in einem durchsuchbaren Index speichern, verschiedene Retrieval-Verfahren vergleichen und die Qualität unserer RAG-Pipeline systematisch bewerten.
Wir müssen den gesamten Corpus dafür nicht von Anfang an kennen. Zunächst konzentrieren wir uns auf ausgewählte Dokumente, an denen sich die einzelnen Verarbeitungsschritte nachvollziehen lassen.
Unser erstes Ziel ist es, aus einem Dokument eine Sammlung sinnvoll strukturierter Retrieval-Einheiten zu erzeugen. Denn bevor ein RAG-System die richtigen Informationen finden kann, müssen wir diese Informationen überhaupt erst zugänglich machen.
So arbeiten wir mit dem Python-Labor
Auch dieses Kapitel begleiten wir mit ausführbaren Python-Experimenten. Die Beispiele befinden sich im Verzeichnis 02_documents_and_chunking/ unseres Laborprojekts.
Wir beginnen damit, ein Markdown-Dokument aus dem Teralune-Corpus einzulesen und seine Struktur zu untersuchen. Anschließend entwickeln wir drei Chunking-Strategien und vergleichen ihre Ergebnisse.
Danach erweitern wir unsere Chunks um Metadaten, verarbeiten unterschiedliche Dateiformate und bauen schließlich ein RAG-System, das Informationen aus mehreren Dokumenten kombiniert.
Die Experimente dieses Kapitels
| Skript | Thema | Abschnitt |
|---|---|---|
01_load_document.py |
Ein Markdown-Dokument einlesen | 2.1 |
02_parse_document.py |
Überschriften und Textabschnitte erkennen | 2.2 |
03_fixed_size_chunking.py |
Text in Chunks fester Tokengröße zerlegen | 2.4 |
04_chunk_overlap.py |
Kontext durch überlappende Chunks erhalten | 2.5 |
05_structure_chunking.py |
Chunks anhand der Dokumentstruktur erzeugen | 2.6 |
06_compare_chunking.py |
Chunking-Strategien beim Retrieval vergleichen | 2.7 |
07_chunk_metadata.py |
Chunks mit Metadaten modellieren | 2.8 |
08_parse_file_formats.py |
CSV, HTML, DOCX und PDF einlesen | 2.9 |
09_rag_with_documents.py |
Eine RAG-Abfrage über mehrere Dokumente ausführen | 2.10 |
Abschnitt 2.3 erläutert die Grundlagen des Chunkings und bereitet die folgenden Experimente vor.
Vorbereitung
Die Experimente verwenden Dokumente aus dem Teralune-Corpus. Die Python-Skripte erwarten diese im Verzeichnis data/teralune-rag-corpus/ unseres Laborprojekts.
Für die Experimente mit Embeddings und Sprachmodellen benötigen wir außerdem den bereits aus Kapitel 1 bekannten OpenAI API-Key.
Er muss in der .env-Datei im Projektverzeichnis hinterlegt sein:
Die Experimente zur Dokumentverarbeitung und zum Chunking können zunächst ohne API-Zugriff ausgeführt werden. Ab Experiment 2.06 verwenden wir die OpenAI API, um Embeddings zu erzeugen und die Retrieval-Ergebnisse zu vergleichen.
Wir starten die Skripte wie gewohnt aus dem Projektverzeichnis, beispielsweise:
Jedes Experiment wird im zugehörigen Abschnitt erläutert. Wir betrachten den entscheidenden Python-Code, ausgewählte Konsolenausgaben und die Erkenntnisse, die wir daraus für unsere RAG-Pipeline gewinnen.
2.1 Von Textschnipseln zu echten Dokumenten
In Kapitel 1 bestand unsere Wissensbasis aus einer einfachen Python-Liste:
documents = [
    "Orbit retries failed webhook deliveries for 72 hours.",
    "Orbit access tokens are valid for 60 minutes.",
    "Orbit retains telemetry data for 90 days.",
    "Orbit limits API clients to 1000 requests per minute.",
    "Orbit exports telemetry data in CSV and JSON format.",
]
Jeder Eintrag enthielt eine eigenständige Information. Wir konnten die Texte unmittelbar in Embeddings umwandeln und für unser Retrieval verwenden.
Bei einem vollständigen Dokument ist das anders. Wir müssen seinen Inhalt zunächst aus einer Datei lesen und anschließend entscheiden, welche Teile für die weitere Verarbeitung relevant sind.
Experiment 2.01: Ein Markdown-Dokument einlesen
Wir beginnen mit D022.md, einer technischen Dokumentation zur Pagination der Orbit-API.
Das Experiment befindet sich in 01_load_document.py.
Wir starten es mit:
Unser erstes Ziel ist einfach: Wir möchten den vollständigen Inhalt der Datei als Python-String einlesen.
Dafür verwenden wir pathlib aus der Python-Standardbibliothek.
from pathlib import Path

PROJECT_DIR = Path(__file__).resolve().parent.parent

DOCUMENT_FILE = (
    PROJECT_DIR
    / "data"
    / "teralune-rag-corpus"
    / "corpus"
    / "public"
    / "D022.md"
)
Mit Path(__file__).resolve() bestimmen wir zunächst den absoluten Pfad unseres Skripts. Über .parent.parent gelangen wir zum Projektverzeichnis.
Anschließend setzen wir den Pfad zur Dokumentdatei zusammen.
Der Vorteil: Das Skript kann unabhängig davon auf die Datei zugreifen, aus welchem Arbeitsverzeichnis wir es starten.
Das eigentliche Einlesen benötigt nur eine Zeile:
read_text() öffnet die Datei, liest ihren Inhalt und liefert ihn als String zurück. Mit encoding="utf-8" legen wir die Zeichenkodierung ausdrücklich fest.
Zur Kontrolle geben wir die Dokumentgröße und die ersten 1000 Zeichen aus:
print(f"Document: {DOCUMENT_FILE.name}")
print(f"Characters: {len(text)}")

print("\nFirst 1000 characters:\n")
print(text[:1000])
Das Ergebnis
Unser Experiment liefert:
Document: D022.md
Characters: 3978

First 1000 characters:

# Pagination and cursors

## Cursor traversal

The default page size is 100 and the maximum is 500.
The response field next_cursor supplies the next request
value for cursor. Treat it as opaque: parsing or editing
its contents is unsupported.
Das Dokument enthält 3978 Zeichen. Bereits die ersten Zeilen zeigen, dass wir es nicht mehr mit einem einzelnen, abgeschlossenen Informationssatz zu tun haben.
Die Datei besitzt eine eigene Struktur:
Pagination and cursors
│
├── Cursor traversal
│   ├── Cursor validity
│   └── Ordering and consistency
│
├── Recover an interrupted traversal
│
└── Query ownership and child pages
Diese Struktur ist fachlich bedeutsam.
Der Abschnitt Cursor validity beschreibt beispielsweise die Gültigkeit eines Pagination-Cursors. Seine übergeordnete Überschrift Cursor traversal macht deutlich, in welchem Zusammenhang diese Information steht.
Wenn wir später einen Textabschnitt aus dem Dokument herauslösen, möchten wir diesen Zusammenhang möglichst erhalten.
Einlesen ist noch kein Parsing
Unser Python-Skript hat die Datei erfolgreich eingelesen. Mehr allerdings nicht.
Die Variable text enthält einen String mit sämtlichen Zeichen der Markdown-Datei.
Python weiß an dieser Stelle noch nicht, dass # Pagination and cursors eine Dokumentüberschrift ist oder dass ### Cursor validity einen Unterabschnitt kennzeichnet.
Diese Informationen sind zwar im Markdown enthalten, wurden aber noch nicht als eigenständige Struktur erfasst.
Dafür benötigen wir einen weiteren Verarbeitungsschritt: Parsing.
Beim Parsing analysieren wir den Inhalt eines Dokuments, um seine Bestandteile und gegebenenfalls ihre Beziehungen zu erkennen.
Für Markdown ist das vergleichsweise einfach, weil Überschriften durch eine explizite Syntax gekennzeichnet sind.
Bei anderen Dateiformaten ist die Situation komplizierter.
Ein PDF kann beispielsweise Text in mehreren Spalten enthalten. Eine DOCX-Datei kann ihre Struktur über Formatvorlagen, Tabellen und Listen ausdrücken. Bei HTML müssen wir zwischen sichtbarem Inhalt und Elementen unterscheiden, die für unsere Wissensbasis keine Bedeutung haben.
Wir werden die Textextraktion aus CSV, HTML, DOCX und PDF in Abschnitt 2.9 anhand konkreter Python-Beispiele untersuchen.
Für unsere weiteren Chunking- und Retrieval-Experimente konzentrieren wir uns jedoch bewusst auf Markdown-Dokumente. So können wir die eigentlichen RAG-Verfahren untersuchen, ohne gleichzeitig die Besonderheiten unterschiedlicher Dateiformate behandeln zu müssen.
Was wir aus dem Experiment mitnehmen
Wir haben erstmals ein vollständiges Dokument aus einer Datei eingelesen. Sein Inhalt steht uns jetzt als Python-String zur Verfügung.
Das ist der erste Schritt unserer Dokumentpipeline:
flowchart LR
    A["Markdown-Datei"] --> B["read_text()"]
    B --> C["Python-String"]

    classDef input fill:#dbeafe,stroke:#2563eb,color:#1e3a8a
    classDef processing fill:#dcfce7,stroke:#16a34a,color:#14532d

    class A,C input
    class B processing
Allerdings haben wir bislang lediglich den Inhalt geladen. Die Überschriften und ihre Beziehungen existieren weiterhin nur als Zeichen innerhalb des Strings.
Im nächsten Experiment werden wir diese Struktur erkennen und das Dokument in seine einzelnen Abschnitte zerlegen.
2.2 Dokumente einlesen und parsen
Im vorherigen Experiment haben wir unser erstes Markdown-Dokument eingelesen. Sein vollständiger Inhalt liegt jetzt als Python-String vor.
Allerdings besteht dieser String aus einer Folge von Zeichen. Die Überschriften und Absätze sind zwar im Markdown erkennbar, wurden von unserem Programm aber noch nicht als eigenständige Bestandteile des Dokuments erfasst.
Genau hier setzt das Parsing an.
Beim Parsing analysieren wir einen Text anhand seiner Syntax und gewinnen daraus eine strukturierte Darstellung. Für unser Experiment bedeutet das: Wir möchten die Überschriften eines Markdown-Dokuments erkennen und ihnen die jeweils folgenden Textabschnitte zuordnen.
Experiment 2.02: Ein Markdown-Dokument parsen
Wir verwenden erneut D022.md, die Dokumentation zur Pagination der Orbit-API.
Unser Ziel ist es, aus dem Dokument eine Liste von Abschnitten zu erzeugen. Jeder Abschnitt soll seine Überschrift und den zugehörigen Text enthalten.
Das Experiment befindet sich in 02_parse_document.py.
Wir starten es mit:
Überschriften erkennen
Markdown ist für unser erstes Parsing-Experiment besonders geeignet, weil Überschriften durch eine einfache Syntax gekennzeichnet werden:
Die Anzahl der #-Zeichen beschreibt die Überschriftenebene.
Unser Parser durchläuft das Dokument Zeile für Zeile. Sobald er eine neue Überschrift erkennt, schließt er den vorherigen Abschnitt ab und beginnt einen neuen.
Dafür verwenden wir drei Variablen:
sections sammelt die erkannten Abschnitte. In current_heading speichern wir die aktuelle Überschrift und current_lines enthält die zugehörigen Textzeilen.
Die eigentliche Verarbeitung erfolgt in einer Schleife:
for line in text.splitlines():
    if line.startswith("#"):
        if current_heading is not None:
            sections.append(
                {
                    "heading": current_heading,
                    "text": "\n".join(current_lines).strip(),
                }
            )

        current_heading = line
        current_lines = []
    else:
        current_lines.append(line)
Mit splitlines() zerlegen wir den Text zunächst in einzelne Zeilen.
Beginnt eine Zeile mit #, behandeln wir sie als Überschrift. Falls bereits ein Abschnitt begonnen wurde, speichern wir diesen als Dictionary in unserer Liste.
Anschließend merken wir uns die neue Überschrift und setzen die Sammlung der Textzeilen zurück.
Alle anderen Zeilen gehören zum aktuellen Abschnitt.
Nach dem Durchlaufen des Dokuments müssen wir noch den letzten Abschnitt speichern, da auf ihn keine weitere Überschrift folgt:
if current_heading is not None:
    sections.append(
        {
            "heading": current_heading,
            "text": "\n".join(current_lines).strip(),
        }
    )

return sections
Damit erhalten wir eine Liste von Dictionaries. Jedes Dictionary enthält die beiden Schlüssel heading und text.
Unser Parser ist bewusst einfach gehalten. Er erkennt Überschriften ausschließlich daran, dass eine Zeile mit # beginnt. Ein vollständiger Markdown-Parser müsste weitere Syntaxregeln berücksichtigen, beispielsweise Codeblöcke, in denen ebenfalls Zeilen mit # vorkommen können.
Für unser strukturiertes Beispieldokument genügt dieser Ansatz zunächst.
Das Ergebnis
Unser Experiment erkennt sechs Abschnitte:
Document: D022.md
Sections: 6

------------------------------------------------------------
# Pagination and cursors
Characters: 0

------------------------------------------------------------
## Cursor traversal
Characters: 542

------------------------------------------------------------
### Cursor validity
Characters: 511

------------------------------------------------------------
### Ordering and consistency
Characters: 624

------------------------------------------------------------
## Recover an interrupted traversal
Characters: 1096

------------------------------------------------------------
## Query ownership and child pages
Characters: 1025
Die Ausgabe zeigt zunächst, dass unser Parser die Überschriften erfolgreich erkannt und den zugehörigen Texten zugeordnet hat.
Interessant ist der erste Abschnitt:
Die Dokumentüberschrift besitzt keinen eigenen Fließtext. Sie beschreibt vielmehr das Thema der darunterliegenden Abschnitte.
Für einen Menschen ist diese Beziehung offensichtlich. Unser Parser bildet sie allerdings noch nicht ausdrücklich ab.
Warum die Dokumenthierarchie wichtig ist
Betrachten wir den Abschnitt Cursor validity.
Sein Text beginnt mit:
A cursor expires after 15 minutes and is bound to workspace,
filters and sort order. An expired cursor requires a new traversal.
Die Information ist auch ohne zusätzliche Überschriften verständlich. Allerdings beschreibt sie nicht irgendeinen Cursor, sondern einen Cursor der Orbit-Pagination.
Im ursprünglichen Dokument ergibt sich dieser Zusammenhang aus der Überschriftenhierarchie:
Unser Parser speichert dagegen lediglich:
Die übergeordneten Überschriften sind darin nicht enthalten.
Wir haben also den Text erfolgreich extrahiert, aber einen Teil seines strukturellen Kontextes verloren.
Bei längeren technischen Dokumenten kann das problematisch werden. Eine Überschrift wie Configuration, Limits oder Troubleshooting sagt allein häufig wenig darüber aus, zu welchem Produkt oder welcher Funktion der Abschnitt gehört.
Für das spätere Retrieval kann es deshalb sinnvoll sein, die vollständige Überschriftenhierarchie zu erhalten.
Parsing ist nicht Chunking
An dieser Stelle müssen wir zwei Verarbeitungsschritte unterscheiden.
Parsing und Chunking sind unterschiedliche Aufgaben
Parsing gewinnt Inhalt und Struktur aus einem Quelldokument. Wir erkennen beispielsweise Überschriften, Absätze, Tabellen oder andere Dokumentbestandteile.
Chunking entscheidet anschließend, welche Teile dieses Inhalts zu eigenständigen Retrieval-Einheiten zusammengefasst werden.
Ein erkannter Dokumentabschnitt muss deshalb nicht automatisch einem Chunk entsprechen. Wir können mehrere Abschnitte zusammenfassen oder einen besonders langen Abschnitt in kleinere Chunks zerlegen.
Unser Parser hat sechs Abschnitte erkannt. Daraus folgt jedoch nicht, dass sechs Chunks für unser RAG-System optimal wären.
Ein Abschnitt kann zu kurz sein, um genügend Kontext zu enthalten. Ein anderer kann so lang sein, dass er mehrere unterschiedliche Themen behandelt.
Außerdem müssen wir entscheiden, ob die Überschriften selbst Bestandteil der Chunks werden sollen.
Diese Entscheidungen gehören nicht mehr zum Parsing, sondern zum Chunking.
Was wir aus dem Experiment mitnehmen
Wir haben aus einem Markdown-String erstmals eine strukturierte Darstellung gewonnen. Unser Parser erkennt Überschriften und ordnet ihnen die folgenden Textabschnitte zu.
Gleichzeitig haben wir gesehen, dass selbst bei einem einfachen Format wie Markdown wichtige Informationen verloren gehen können, wenn wir die Dokumenthierarchie nicht berücksichtigen.
Unsere bisherige Verarbeitung sieht damit so aus:
flowchart LR
    A["Markdown-Datei"] --> B["Einlesen"]
    B --> C["Python-String"]
    C --> D["Parsing"]
    D --> E["Abschnitte mit Überschriften"]

    classDef input fill:#dbeafe,stroke:#2563eb,color:#1e3a8a
    classDef processing fill:#dcfce7,stroke:#16a34a,color:#14532d
    classDef retrieval fill:#fef3c7,stroke:#d97706,color:#78350f

    class A,C input
    class B,D processing
    class E retrieval
Wir besitzen jetzt einzelne Textabschnitte, aber noch keine bewusst ausgewählten Retrieval-Einheiten.
Im nächsten Abschnitt untersuchen wir deshalb, warum RAG-Systeme Dokumente überhaupt in Chunks zerlegen und welche Zielkonflikte dabei entstehen.
2.3 Warum RAG-Systeme Dokumente chunken
Wir können inzwischen Dokumente einlesen und ihre Struktur erkennen. Doch damit haben wir noch nicht entschieden, welche Teile eines Dokuments unser Retriever später durchsuchen soll.
Technisch könnten wir das gesamte Dokument D022.md als einen einzigen Text in ein Embedding umwandeln. Mit seinen 3978 Zeichen wäre das problemlos möglich.
Bei einem umfangreichen technischen Handbuch sieht die Situation jedoch anders aus.
Stellen wir uns ein Dokument vor, das Authentifizierung, Webhooks, Pagination, Datenexporte und Benutzerverwaltung beschreibt. Eine Benutzerfrage betrifft ausschließlich die Gültigkeit eines Pagination-Cursors.
Wenn wir das gesamte Handbuch als eine Retrieval-Einheit behandeln, repräsentiert sein Embedding gleichzeitig zahlreiche unterschiedliche Themen. Die Information zur Cursor-Gültigkeit ist zwar enthalten, ihr semantisches Signal kann jedoch durch die übrigen Inhalte überlagert werden.
Selbst wenn unser Retriever das richtige Dokument findet, müssten wir anschließend große Mengen irrelevanten Textes an das Sprachmodell übergeben.
Chunking löst dieses Problem, indem wir Dokumente in kleinere, gezielt durchsuchbare Einheiten zerlegen.
Der Zielkonflikt zwischen Präzision und Kontext
Die Größe eines Chunks beeinflusst, welche Informationen gemeinsam repräsentiert und später abgerufen werden.
Kleine Chunks können sich auf einen eng begrenzten Sachverhalt konzentrieren. Dadurch lassen sie sich häufig gezielter mit einer Benutzerfrage vergleichen.
Allerdings besteht die Gefahr, dass wichtige Zusammenhänge verloren gehen.
Betrachten wir beispielsweise diese beiden Sätze:
Beide Informationen gehören fachlich zusammen. Werden sie auf unterschiedliche Chunks verteilt, findet unser Retriever möglicherweise nur eine davon.
Große Chunks enthalten dagegen mehr zusammenhängenden Kontext. Gleichzeitig steigt die Wahrscheinlichkeit, dass sie mehrere Themen behandeln und für eine konkrete Frage unnötige Informationen enthalten.
Der Zielkonflikt lässt sich so darstellen:
| Eigenschaft | Kleine Chunks | Große Chunks |
|---|---|---|
| Thematischer Fokus | Häufig präziser | Häufig breiter |
| Zusammenhängender Kontext | Kann verloren gehen | Bleibt eher erhalten |
| Irrelevante Informationen | Tendenziell weniger | Tendenziell mehr |
| Anzahl der Chunks | Höher | Niedriger |
| Risiko ungünstiger Grenzen | Höher bei willkürlicher Aufteilung | Geringer, aber nicht ausgeschlossen |
Die Tabelle beschreibt typische Tendenzen, keine allgemeingültigen Regeln.
Ein kleiner Chunk ist nicht automatisch präziser, und ein großer Chunk enthält nicht zwangsläufig den richtigen Kontext.
Entscheidend ist, welche Informationen für die späteren Benutzerfragen gemeinsam benötigt werden.
Was macht einen guten Chunk aus?
Ein geeigneter Chunk sollte möglichst einen fachlich zusammenhängenden Inhalt repräsentieren.
Für unser Pagination-Dokument könnte das beispielsweise ein Abschnitt über die Gültigkeit von Cursorn sein.
Dabei spielen mehrere Eigenschaften eine Rolle:
- Thematische Kohärenz: Der Chunk behandelt möglichst einen zusammenhängenden Sachverhalt.
- Ausreichender Kontext: Die enthaltenen Aussagen bleiben auch außerhalb des vollständigen Dokuments verständlich.
- Geeignete Größe: Der Chunk ist weder unnötig umfangreich noch so klein, dass wichtige Informationen fehlen.
- Nachvollziehbare Herkunft: Wir können später feststellen, aus welchem Dokument und Abschnitt die Information stammt.
Diese Eigenschaften beeinflussen die Qualität unserer Retrieval-Einheiten. Sie garantieren jedoch noch nicht, dass ein Retriever die richtigen Chunks findet.
Dafür müssen wir die Strategien anhand konkreter Suchfragen vergleichen.
Chunking ist eine experimentelle Entscheidung
Eine allgemein optimale Chunkgröße gibt es nicht.
Welche Strategie geeignet ist, hängt unter anderem von der Dokumentstruktur, dem Embedding-Modell, den Benutzerfragen und dem verwendeten Retrieval-Verfahren ab.
Wir sollten deshalb nicht einfach eine Chunkgröße festlegen und davon ausgehen, dass sie für alle Dokumente funktioniert.
Stattdessen beginnen wir mit einer möglichst einfachen Strategie und untersuchen anschließend, ob Änderungen bessere Ergebnisse liefern.
Was ist eine Baseline?
Eine Baseline ist ein einfacher, nachvollziehbarer Ausgangspunkt, mit dem wir komplexere Verfahren vergleichen.
Sie muss nicht besonders leistungsfähig sein. Ihre Aufgabe besteht darin, eine Referenz zu liefern, anhand derer wir Verbesserungen oder Verschlechterungen messen können.
In unseren Experimenten verwenden wir zunächst Fixed-Size-Chunking als Baseline. Dabei zerlegen wir einen Text in Abschnitte mit einer festen Anzahl von Token.
Anschließend vergleichen wir diese einfache Strategie mit Overlap und strukturorientiertem Chunking.
Erst durch diesen Vergleich können wir beurteilen, ob der zusätzliche Aufwand einer komplexeren Strategie einen messbaren Nutzen bringt.
Drei Strategien für unsere Experimente
Wir werden im Folgenden drei unterschiedliche Verfahren untersuchen.
Fixed-Size-Chunking zerlegt einen Text in Abschnitte mit einer festen Anzahl von Token. Die Dokumentstruktur wird dabei ignoriert. Das Verfahren ist einfach, schnell und gut reproduzierbar.
Fixed-Size-Chunking mit Overlap erweitert diese Strategie. Benachbarte Chunks überlappen sich, sodass Informationen an einer Chunkgrenze teilweise in beiden Chunks enthalten sind.
Strukturorientiertes Chunking verwendet dagegen die vorhandene Dokumentstruktur. Bei Markdown können beispielsweise Überschriften und ihre Hierarchie bestimmen, welche Inhalte zusammengehören.
Alle drei Strategien verarbeiten denselben Dokumentinhalt. Sie unterscheiden sich lediglich darin, wie sie daraus Retrieval-Einheiten erzeugen.
Das ermöglicht uns später einen kontrollierten Vergleich.
Dabei werden wir nicht nur untersuchen, wie die Chunks aussehen, sondern auch, welche Chunks bei einer konkreten Benutzerfrage im Retrieval gefunden werden.
Darüber hinaus existieren weitere Verfahren, etwa semantisches Chunking, bei dem die Grenzen anhand inhaltlicher Ähnlichkeiten bestimmt werden, sowie hierarchisches und adaptives Chunking. Wir beschränken uns zunächst auf drei grundlegende Strategien, um ihre Unterschiede und Auswirkungen auf das Retrieval nachvollziehbar untersuchen zu können.
Im nächsten Abschnitt beginnen wir mit unserer Baseline: Fixed-Size-Chunking. Wir werden sehen, dass ein technisch einfacher Algorithmus bereits brauchbare Retrieval-Einheiten erzeugen kann, seine Grenzen aber keinerlei Rücksicht auf den Inhalt nehmen.
2.4 Fixed-Size-Chunking: die einfache Baseline
Wir beginnen mit der einfachsten Chunking-Strategie: Fixed-Size-Chunking.
Das Prinzip ist unkompliziert. Wir zerlegen einen Text in Abschnitte mit einer festgelegten Anzahl von Token. Sobald ein Chunk seine maximale Größe erreicht hat, beginnt der nächste.
Dabei berücksichtigen wir weder Satzgrenzen noch Absätze oder Überschriften. Entscheidend ist ausschließlich die Anzahl der Token.
Genau deshalb eignet sich dieses Verfahren als Baseline. Es lässt sich einfach implementieren, arbeitet deterministisch und liefert uns einen Ausgangspunkt für den Vergleich mit komplexeren Strategien.
Experiment 2.03: Fixed-Size-Chunking implementieren
Wir verwenden weiterhin das Dokument D022.md mit seinen Informationen zur Pagination und zur Gültigkeit von Cursorn.
Unser Ziel ist es, den vollständigen Dokumenttext in Chunks mit jeweils maximal 150 Token zu zerlegen.
Das Experiment befindet sich in 03_fixed_size_chunking.py.
Wir starten es mit:
Warum wir Token statt Zeichen zählen
Wir könnten einen Text auch nach einer festen Anzahl von Zeichen aufteilen. Für die Verarbeitung durch Sprachmodelle ist die Anzahl der Token jedoch die relevantere Größe.
Wie wir in Kapitel 1 gesehen haben, verarbeiten Sprachmodelle Texte nicht direkt als Zeichenfolgen. Ein Tokenizer zerlegt den Text zunächst in Token.
Dabei entspricht ein Token weder zwingend einem Wort noch einer festen Anzahl von Zeichen.
Deshalb verwenden wir für unser Experiment den Tokenizer tiktoken.
Mit get_encoding() laden wir die gewünschte Tokenisierung. Anschließend können wir einen Text in Token-IDs umwandeln:
Die resultierende Liste enthält ganze Zahlen. Jede Zahl repräsentiert eine Token-ID.
Für unser Dokument erhalten wir:
Der Text besteht bei dieser Tokenisierung also aus 706 Token.
Tokenisierung und Embedding-Modell
Die Anzahl der Token hängt vom verwendeten Tokenizer ab.
In unserem Experiment verwenden wir cl100k_base, um die Chunkgrenzen reproduzierbar festzulegen. Andere Tokenizer können denselben Text in eine andere Anzahl von Token zerlegen.
Bei einer produktiven RAG-Pipeline sollten wir deshalb prüfen, welche Tokenisierung und welche Eingabelimits für das verwendete Embedding-Modell gelten.
Den Text in Chunks zerlegen
Das eigentliche Chunking benötigt nur wenige Zeilen:
encoding = tiktoken.get_encoding("o200k_base")
tokens = encoding.encode(text)

chunks = []

for start in range(0, len(tokens), CHUNK_SIZE):
    chunk_tokens = tokens[start : start + CHUNK_SIZE]
    chunk_text = encoding.decode(chunk_tokens)
    chunks.append(chunk_text)
Betrachten wir die entscheidenden Schritte.
Zunächst wandeln wir den vollständigen Text in Token-IDs um:
Anschließend durchlaufen wir diese Liste in Schritten von chunk_size:
Bei einer Chunkgröße von 150 ergeben sich die Startpositionen 0, 150, 300, 450 und 600.
Für jede Position entnehmen wir maximal 150 Token:
Mit encoding.decode() wandeln wir die Token-IDs anschließend wieder in einen lesbaren Text um.
Die fertigen Textabschnitte speichern wir in einer Liste.
Unsere Funktion gibt damit list[str] zurück. Jeder Eintrag enthält den Text eines Chunks.
Das Ergebnis: Fünf Chunks
Wir wir setzen die Chunkgröße auf 150 Token:
Die Ausgabe zeigt:
Das Ergebnis lässt sich unmittelbar nachvollziehen:
| Chunk | Tokenpositionen | Anzahl Token |
|---|---|---|
| 1 | 0 bis 149 | 150 |
| 2 | 150 bis 299 | 150 |
| 3 | 300 bis 449 | 150 |
| 4 | 450 bis 599 | 150 |
| 5 | 600 bis 705 | 106 |
| Gesamt | 706 |
Die ersten vier Chunks enthalten jeweils 150 Token. Der letzte Chunk enthält die verbleibenden 106 Token.
Damit erfüllt unser Algorithmus genau die Vorgabe.
Allerdings sagt uns die korrekte Anzahl der Token noch nichts darüber, ob die entstandenen Chunks fachlich sinnvoll sind.
Das Problem mit den Chunkgrenzen
Unser Algorithmus kennt die Bedeutung des Textes nicht. Er weiß auch nicht, wo ein Satz endet oder ein neuer Abschnitt beginnt.
Er trennt den Text ausschließlich anhand der Tokenpositionen.
Das wird in unserer tatsächlichen Ausgabe sichtbar.
An einer Chunkgrenze wird beispielsweise das Wort nonoverlapping aufgeteilt:
Der folgende Chunk beginnt mit:
Der Grund dafür ist, dass der Tokenizer das Wort in mehrere Token zerlegt hat und unsere Grenze zwischen diesen Token liegt.
Auch Satzgrenzen können mitten durch einen Chunk verlaufen.
Das ist kein Implementierungsfehler. Unser Algorithmus arbeitet exakt so, wie wir ihn definiert haben.
Das Problem liegt vielmehr darin, dass eine feste Anzahl von Token keine fachlich sinnvolle Textgrenze garantiert.
Warum das für Retrieval problematisch sein kann
Stellen wir uns vor, eine wichtige Information steht genau an einer Chunkgrenze:
Der folgende Chunk enthält die Fortsetzung:
Der erste Chunk enthält eine unvollständige Aussage. Der zweite enthält zwar die Fortsetzung, aber nicht mehr den vollständigen Zusammenhang.
Wenn wir beide Chunks unabhängig voneinander in Embeddings umwandeln, repräsentiert jeder Vektor nur einen Teil der ursprünglichen Information.
Bei einer späteren Suchanfrage kann das dazu führen, dass der Retriever einen Chunk findet, der für sich genommen keine ausreichende Antwort ermöglicht.
Ein weiteres Problem entsteht, wenn eine Überschrift und ihr zugehöriger Text in unterschiedliche Chunks geraten.
Dann kann ein Chunk zwar eine technische Aussage enthalten, aber nicht mehr erkennen lassen, zu welchem Thema oder welcher Funktion sie gehört.
Diese Probleme treten nicht zwangsläufig bei jeder Chunkgrenze auf. Sie sind jedoch eine direkte Folge unseres Verfahrens.
Warum Fixed-Size-Chunking trotzdem sinnvoll ist
Trotz dieser Einschränkungen ist Fixed-Size-Chunking keineswegs unbrauchbar.
Das Verfahren besitzt mehrere praktische Vorteile.
Es ist einfach. Die Implementierung benötigt keine aufwendige Dokumentanalyse und keine zusätzlichen Modellaufrufe.
Es ist vorhersehbar. Wir können die maximale Chunkgröße direkt kontrollieren und die Anzahl der entstehenden Chunks abschätzen.
Es funktioniert unabhängig vom Dokumentformat. Sobald wir einen Text extrahiert haben, können wir denselben Algorithmus darauf anwenden.
Es ist reproduzierbar. Bei identischem Text, Tokenizer und identischer Chunkgröße entstehen dieselben Chunks.
Gerade für eine erste RAG-Pipeline kann diese Einfachheit wertvoll sein.
Allerdings sollten wir Fixed-Size-Chunking nicht deshalb einsetzen, weil es besonders einfach ist, sondern weil seine Ergebnisse für unseren Anwendungsfall ausreichend gut sind.
Ob das zutrifft, müssen wir später anhand konkreter Retrieval-Fragen überprüfen.
Was wir aus dem Experiment mitnehmen
Wir haben unseren ersten Chunking-Algorithmus implementiert.
Aus einem Dokument mit 706 Token sind fünf Chunks entstanden. Vier davon enthalten jeweils 150 Token, der letzte enthält 106 Token.
Die Implementierung ist kurz und nachvollziehbar. Gleichzeitig haben wir ihre wichtigste Schwäche beobachtet: Die Chunkgrenzen entstehen unabhängig von der Bedeutung und Struktur des Textes.
Dadurch können Wörter, Sätze und fachlich zusammengehörende Informationen auf unterschiedliche Chunks verteilt werden.
2.5 Overlap: Kontext an Grenzen erhalten
Eine verbreitete Erweiterung des Fixed-Size-Chunkings ist Overlap.
Dabei beginnt der nächste Chunk nicht erst dort, wo der vorherige endet. Stattdessen wird ein Teil des vorherigen Chunks wiederholt.
Das soll verhindern, dass wichtige Informationen ausschließlich aufgrund einer ungünstigen Chunkgrenze auseinandergerissen werden.
Experiment 2.04: Fixed-Size-Chunking mit Overlap
Wir verwenden weiterhin das Dokument D022.md und behalten die Chunkgröße von 150 Token bei. Zusätzlich legen wir einen Overlap von 30 Token fest.
Aufruf:
Für unser Experiment verwenden wir folgende Einstellungen:
Die entscheidende Änderung gegenüber dem vorherigen Experiment ist die Schrittweite:
Damit verschieben wir das Fenster bei jedem Schritt nur um 120 Token.
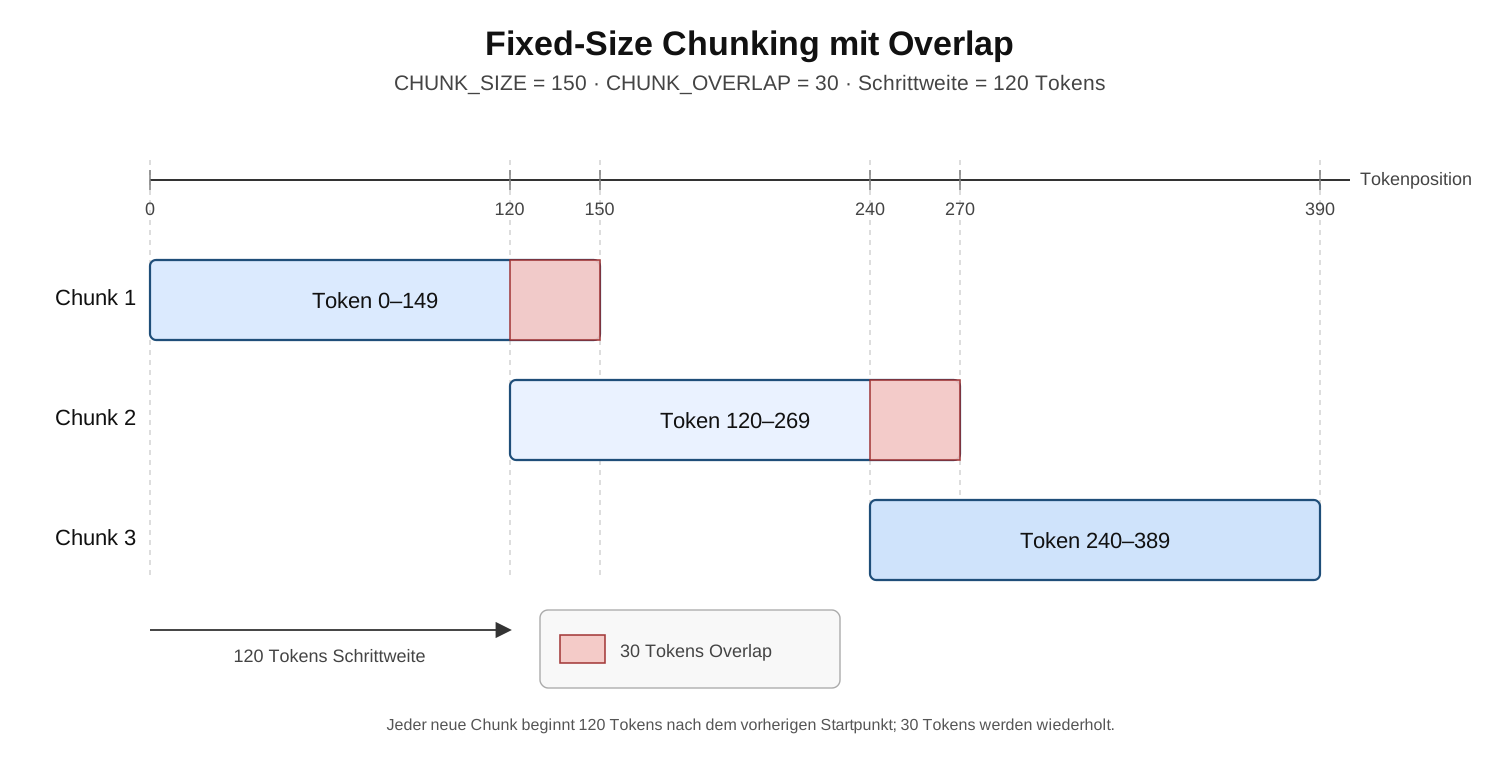
Die jeweils letzten 30 Token eines Chunks erscheinen also erneut im folgenden Chunk.
In unserem Python-Code wird die berechnete Schrittweite direkt in der Schleife verwendet:
for start in range(0, len(tokens), step_size):
    chunk_tokens = tokens[start : start + CHUNK_SIZE]

    if not chunk_tokens:
        break

    chunks.append(encoding.decode(chunk_tokens))
Die Größe des Fensters bleibt unverändert. Lediglich seine Startposition verschiebt sich um weniger Token als zuvor.
Das Ergebnis
Bei D022.md entstehen dadurch sechs statt fünf Chunks.
Das Ergebnis zeigt den Vorteil unmittelbar.
Im ersten Versuch war die Information zur Cursor-Gültigkeit über eine Chunkgrenze verteilt. Mit Overlap beginnt Chunk 2 bereits mit einem Teil des vorherigen Kontextes:
15 minutes and is bound to workspace, filters and sort order.
An expired cursor requires a new traversal. Do not repeatedly retry
the same expired value while the local process waits for a downstream
file writer.
Die wichtige Information ist dadurch nicht mehr ausschließlich von einer ungünstigen Grenze abhängig.
Overlap löst nicht alle Probleme
Overlap hat das grundlegende Problem willkürlicher Chunkgrenzen nicht beseitigt.
Der letzte Chunk beginnt weiterhin mit:
Die Grenze kann also nach wie vor mitten in einem Wort, Satz oder fachlichen Zusammenhang liegen.
Overlap sorgt lediglich dafür, dass ein Teil der Information zusätzlich im vorherigen Chunk vorhanden ist.
Dafür bezahlen wir mit Redundanz.
Aus fünf Chunks sind sechs geworden. Wiederholter Text muss ebenfalls eingebettet und gespeichert werden. Außerdem können beim späteren Retrieval mehrere nahezu identische Chunks unter den besten Treffern erscheinen.
Mehr Overlap bedeutet deshalb nicht automatisch besseres Retrieval.
Was wir aus dem Experiment mitnehmen
Wir haben jetzt zwei Strategien kennengelernt:
flowchart TD
    A["Fixed Size"] --> B["Einfache, aber willkürliche Grenzen"]
    C["Fixed Size + Overlap"] --> D["Weniger Kontextverlust an Grenzen,<br/>aber mehr Redundanz"]

    classDef input fill:#DBEAFE,stroke:#2563EB,color:#1E40AF
    classDef retrieval fill:#FFEDD5,stroke:#EA580C,color:#9A3412

    class A,C input
    class B,D retrieval
Beide Verfahren ignorieren allerdings die Struktur des Dokuments.
Dabei enthält unser Markdown-Dokument bereits Hinweise darauf, wo sinnvolle Grenzen liegen könnten: seine Überschriften.
Diese Information nutzen wir im nächsten Experiment.
2.6 Strukturorientiertes Chunking
Unsere bisherigen Chunking-Strategien haben den Text ausschließlich anhand seiner Tokenpositionen zerlegt. Mit Overlap konnten wir den Kontextverlust an Chunkgrenzen reduzieren, die Grenzen selbst blieben jedoch willkürlich.
Dabei besitzt unser Dokument D022.md bereits eine explizite Markdown-Hierarchie.
Statt alle 150 Token eine Grenze zu setzen, können wir die vorhandenen Überschriften verwenden, um fachlich zusammengehörende Abschnitte zu bilden.
Dabei wollen wir den übergeordneten Kontext nicht verlieren.
Aus:
soll deshalb nicht nur der Chunk:
entstehen.
Wir möchten stattdessen den vollständigen Überschriftenpfad erhalten:
Pagination and cursors
> Cursor traversal
> Cursor validity
A cursor expires after 15 minutes and is bound to workspace,
filters and sort order.
So bleibt erkennbar, zu welchem Thema ein Textabschnitt gehört, auch wenn wir ihn später unabhängig vom ursprünglichen Dokument verarbeiten.
Experiment 2.05: Strukturorientiertes Chunking
Wir entwickeln einen einfachen Markdown-Parser, der die Überschriftenhierarchie berücksichtigt und daraus eigenständige Chunks erzeugt.
Das Experiment befindet sich in 05_structure_chunking.py.
Aufruf:
Die Überschriftenhierarchie verwalten
Unsere Funktion structure_chunks() verwendet ein Dictionary, um die jeweils gültigen Überschriften zu speichern:
Die Schlüssel in headings entsprechen den Überschriftenebenen. Die Werte enthalten die jeweiligen Überschriftentexte.
Bei unserem Beispiel ergibt sich:
Während wir das Dokument Zeile für Zeile durchlaufen, erkennen wir Überschriften anhand des führenden #.
Die Ebene berechnen wir aus der Anzahl dieser Zeichen:
Mit lstrip("#") entfernen wir die führenden #-Zeichen. Die Differenz zur ursprünglichen Zeilenlänge ergibt die Überschriftenebene.
Anschließend speichern wir die neue Überschrift im Dictionary.
Ungültige Unterebenen entfernen
Eine wichtige Besonderheit entsteht, wenn wir von einer tieferen Überschriftenebene zu einer höheren zurückkehren.
Betrachten wir diese Struktur:
# Pagination and cursors
## Cursor traversal
### Cursor validity
## Recover an interrupted traversal
Sobald wir Recover an interrupted traversal erreichen, gehört Cursor validity nicht mehr zum aktuellen Überschriftenpfad.
Deshalb entfernen wir alle gespeicherten Überschriften, deren Ebene tiefer liegt als die neue Überschrift:
Damit bleibt die Hierarchie konsistent.
Ohne diesen Schritt könnten Chunks fälschlicherweise Überschriften aus vorherigen Abschnitten übernehmen.
Einen Chunk erzeugen
Bevor wir mit einer neuen Überschrift beginnen, speichern wir den bisher gesammelten Text als Chunk.
Der entsprechende Ausschnitt unserer Funktion lautet:
if current_level is not None and "\n".join(current_lines).strip():
chunks.append(
{
"headings": dict(headings),
"level": current_level,
"text": "\n".join(current_lines).strip(),
}
)
Jeder Chunk enthält drei Informationen:
| Schlüssel | Bedeutung |
|---|---|
headings |
Vollständige Überschriftenhierarchie |
level |
Ebene der aktuellen Überschrift |
text |
Inhalt des Abschnitts |
Besonders wichtig ist dict(headings).
Damit erstellen wir eine Kopie des aktuellen Überschriften-Dictionarys. Würden wir stattdessen das ursprüngliche Dictionary speichern, könnten spätere Änderungen an der Hierarchie auch bereits erzeugte Chunks beeinflussen.
Der Parser bewahrt damit für jeden Chunk den Überschriftenpfad, der zum Zeitpunkt seiner Erstellung gültig war.
Das Ergebnis: Fünf strukturierte Chunks
Unser Experiment erzeugt aus D022.md insgesamt fünf Chunks.
Anders als beim Fixed-Size-Chunking folgen ihre Grenzen jetzt den Markdown-Abschnitten.
Der zweite Chunk sieht so aus:
Pagination and cursors > Cursor traversal > Cursor validity
A cursor expires after 15 minutes and is bound to workspace, filters
and sort order. An expired cursor requires a new traversal. Do not
repeatedly retry the same expired value while the local process waits
for a downstream file writer.
For a slow consumer, buffer a page durably before fetching the next
one. If the local checkpoint is lost, restart from an explicit time
interval and reconcile identifiers. A cursor lifetime is separate
from the OAuth token lifetime: renewing a token does not renew a cursor.
Hier bleiben mehrere fachlich zusammengehörende Informationen erhalten.
Wir erfahren, dass ein Cursor nach 15 Minuten abläuft, an bestimmte Abfrageparameter gebunden ist und nach seinem Ablauf eine neue Traversierung erforderlich wird.
Außerdem enthält der Chunk die wichtige Unterscheidung zwischen der Gültigkeit eines Cursors und der eines OAuth-Tokens.
Diese Informationen stehen jetzt gemeinsam in einer Retrieval-Einheit.
Auch der Abschnitt Ordering and consistency behält seinen übergeordneten Kontext:
Die Überschriftenhierarchie macht die Bedeutung des Abschnitts nachvollziehbar, ohne dass wir dafür das vollständige Dokument benötigen.
Ist strukturorientiertes Chunking automatisch besser?
Unser Ergebnis sieht zunächst überzeugend aus.
Die Chunkgrenzen folgen fachlichen Abschnitten. Zusammengehörende Informationen bleiben erhalten, und jeder Chunk besitzt einen nachvollziehbaren Überschriftenpfad.
Allerdings hat auch diese Strategie Grenzen.
Dokumentabschnitte sind nicht automatisch geeignete Retrieval-Einheiten.
Ein Abschnitt kann nur aus einem Satz bestehen. Ein anderer kann mehrere Tausend Token umfassen und unterschiedliche Sachverhalte behandeln.
Unser einfacher Parser berücksichtigt außerdem keine maximale Chunkgröße. Er würde einen sehr langen Markdown-Abschnitt vollständig übernehmen.
In einer produktiven Pipeline könnten wir deshalb strukturorientiertes Chunking mit einer zusätzlichen Größenbegrenzung kombinieren. Lange Abschnitte würden dann weiter unterteilt, während die Überschriftenhierarchie erhalten bleibt.
Für unseren Vergleich verwenden wir zunächst bewusst die einfache Variante.
Denn ein sauber strukturierter Chunk ist noch kein Beweis für besseres Retrieval.
Entscheidend ist, ob unser Retriever bei einer konkreten Benutzerfrage die richtigen Informationen findet.
Was wir aus dem Experiment mitnehmen
Wir haben eine dritte Chunking-Strategie implementiert, die vorhandene Dokumentstrukturen berücksichtigt.
Aus D022.md entstehen fünf Chunks, deren Grenzen den Markdown-Abschnitten folgen. Zusätzlich speichern wir für jeden Chunk den vollständigen Überschriftenpfad.
Damit unterscheiden sich unsere drei Strategien grundlegend:
| Strategie | Grundlage der Chunkgrenzen | Besonderheit |
|---|---|---|
| Fixed Size | Feste Anzahl von Token | Einfach und reproduzierbar |
| Fixed Size + Overlap | Feste Anzahl von Token mit Überlappung | Wiederholt Kontext an Grenzen |
| Structure-Aware | Markdown-Überschriften | Erhält fachliche Abschnitte und Überschriftenhierarchie |
Im nächsten Experiment vergleichen wir die drei Strategien unter denselben Retrieval-Bedingungen.
Dabei interessiert uns nicht mehr, welche Chunks für einen Menschen am schönsten aussehen, sondern welche Strategie die relevanten Informationen für eine Benutzerfrage am besten auffindbar macht.
2.7 Chunking-Strategien im Retrieval vergleichen
Wir haben drei Verfahren kennengelernt, um Dokumente in Chunks zu zerlegen:
- Fixed-Size-Chunking mit 150 Token
- Fixed-Size-Chunking mit 150 Token und 30 Token Overlap
- Strukturorientiertes Chunking anhand der Markdown-Überschriften
Bisher haben wir hauptsächlich untersucht, wie die erzeugten Chunks aussehen. Dabei erschien das strukturorientierte Chunking besonders überzeugend, weil es fachliche Abschnitte und ihre Überschriftenhierarchie erhält.
Aber ein gut lesbarer Chunk ist nicht automatisch ein guter Retrieval-Treffer.
Ob eine Chunking-Strategie geeignet ist, zeigt sich erst, wenn wir mit ihren Chunks tatsächlich nach Informationen suchen.
Experiment 2.06: Drei Chunking-Strategien vergleichen
Wir verwenden erneut das Dokument D022.md und stellen eine konkrete Frage zur Pagination der Orbit-API:
Darf ich während einer Cursorfolge den Gerätefilter ändern?
Unser Ziel ist es, die relevanten Informationen aus dem Dokument zu finden.
Dafür erzeugen wir mit jeder Chunking-Strategie eine eigene Sammlung von Chunks. Anschließend wandeln wir diese Chunks in Embeddings um und vergleichen sie mit dem Embedding unserer Frage.
Das Experiment befindet sich in 06_compare_chunking.py.
Aufruf:
Gleiche Frage, unterschiedliche Chunks
Für einen aussagekräftigen Vergleich müssen wir die Bedingungen möglichst konstant halten.
Wir verwenden deshalb für alle drei Strategien dasselbe Quelldokument, dieselbe Benutzerfrage und dasselbe Embedding-Modell.
Lediglich die Aufteilung des Dokuments unterscheidet sich.
Der Ablauf sieht folgendermaßen aus:
flowchart TD
    A["Dokument D022.md"] --> B["Fixed Size"]
    A --> C["Fixed Size + Overlap"]
    A --> D["Structure-Aware"]

    B --> E["Chunks"]
    C --> F["Chunks"]
    D --> G["Chunks"]

    E --> H["Embeddings"]
    F --> H
    G --> H

    Q["Benutzerfrage"] --> R["Frage-Embedding"]
    R --> S["Ähnlichkeitsvergleich"]
    H --> S

    S --> T["Top-3-Treffer je Strategie"]

    classDef input fill:#DBEAFE,stroke:#2563EB,color:#1E40AF
    classDef processing fill:#DCFCE7,stroke:#16A34A,color:#166534
    classDef retrieval fill:#FFEDD5,stroke:#EA580C,color:#9A3412
    classDef evaluation fill:#F3E8FF,stroke:#9333EA,color:#6B21A8

    class A,Q input
    class H,R processing
    class B,C,D,E,F,G,S retrieval
    class T evaluation
Die Embeddings ermöglichen uns, die semantische Ähnlichkeit zwischen der Frage und den einzelnen Chunks zu bestimmen.
Wie bereits in Kapitel 1 verwenden wir dafür die Kosinusähnlichkeit.
Die Ähnlichkeit berechnen
Für jeden Chunk berechnen wir einen Ähnlichkeitswert zur Benutzerfrage.
Je höher dieser Wert ausfällt, desto ähnlicher sind sich die beiden Embeddings hinsichtlich ihrer Richtung im Vektorraum.
Anschließend sortieren wir die Treffer nach ihrer Ähnlichkeit und betrachten die drei besten Ergebnisse.
Wichtig ist dabei: Ein hoher Ähnlichkeitswert bedeutet nicht automatisch, dass ein Chunk die Frage korrekt beantwortet.
Der Wert beschreibt die Nähe zweier Embeddings. Ob der gefundene Text tatsächlich die benötigte Information enthält, müssen wir gesondert beurteilen.
Das Ergebnis
Unser Experiment liefert folgende Ähnlichkeitswerte für die jeweils drei besten Treffer:
| Rang | Fixed Size | Fixed Size + Overlap | Structure-Aware |
|---|---|---|---|
| 1 | 0,3611 | 0,3611 | 0,3885 |
| 2 | 0,2957 | 0,2958 | 0,3254 |
| 3 | 0,2383 | 0,2809 | 0,3210 |
In diesem Experiment erzielt das strukturorientierte Chunking auf allen drei Positionen die höchsten Ähnlichkeitswerte.
Besonders beim ersten Treffer ist der Unterschied sichtbar:
Das Ergebnis ist plausibel.
Beim strukturorientierten Chunking bleibt der vollständige Abschnitt mit seinem Überschriftenpfad erhalten. Der relevante Text wird dadurch gemeinsam mit seinem fachlichen Kontext eingebettet.
Beim Fixed-Size-Chunking können dagegen Informationen über mehrere Chunks verteilt sein.
Was bringt Overlap in diesem Vergleich?
Interessanterweise erzielen Fixed Size und Fixed Size mit Overlap beim besten Treffer denselben Wert von 0,3611.
Der Overlap verbessert den ersten Treffer in unserem Experiment also nicht.
Beim dritten Treffer ist allerdings ein Unterschied sichtbar:
Durch die Überlappung entstehen andere Textausschnitte, die teilweise mehr relevanten Kontext enthalten.
Das bedeutet jedoch nicht, dass Overlap grundsätzlich zu besseren Ergebnissen führt.
Je nach Frage und Chunkgrenze kann er helfen, wirkungslos bleiben oder zusätzliche redundante Treffer erzeugen.
Können wir daraus einen Sieger ableiten?
Noch nicht.
Wir haben bisher ein Dokument und eine einzige Benutzerfrage untersucht.
Das strukturorientierte Chunking erzielt hier höhere Ähnlichkeitswerte. Daraus können wir aber nicht schließen, dass es bei anderen Dokumenten und Fragen ebenfalls überlegen ist.
Außerdem vergleichen wir bisher nur Ähnlichkeitswerte.
Für die tatsächliche Qualität eines RAG-Systems sind weitere Fragen entscheidend:
- Enthält der gefundene Chunk die benötigte Information?
- Werden alle relevanten Informationen gefunden?
- Enthalten die besten Treffer unnötige Wiederholungen?
- Kann das Sprachmodell mit den gefundenen Informationen die Frage korrekt beantworten?
Ein Chunk mit einem niedrigeren Ähnlichkeitswert kann die gesuchte Information vollständig enthalten. Umgekehrt kann ein sehr ähnlicher Chunk wichtige Details auslassen.
Ähnlichkeit ist keine Retrieval-Qualität
Kosinusähnlichkeit misst die Nähe von Embeddings im Vektorraum.
Sie ist ein nützliches Signal für das Ranking, aber kein direkter Qualitätsmaßstab für die fachliche Relevanz eines Treffers.
Für eine belastbare Bewertung benötigen wir mehrere Testfragen und bekannte relevante Dokumentstellen. Erst damit können wir beispielsweise messen, wie häufig relevante Informationen unter den besten Treffern erscheinen.
Eine systematische Evaluation unserer Retrieval-Pipeline behandeln wir in einem späteren Kapitel.
Was wir aus dem Experiment mitnehmen
Wir haben unsere drei Chunking-Strategien erstmals unter vergleichbaren Bedingungen getestet.
Das strukturorientierte Chunking erzielt bei unserer Frage die höchsten Ähnlichkeitswerte. Overlap verbessert einzelne Treffer gegenüber Fixed Size, führt aber nicht durchgehend zu höheren Werten.
Damit haben wir zwei wichtige Erkenntnisse gewonnen.
Erstens: Die Art, wie wir Dokumente zerlegen, beeinflusst die Embeddings und damit die Reihenfolge der Retrieval-Treffer.
Zweitens: Wir sollten Chunking-Strategien anhand konkreter Suchfragen vergleichen, statt allein die Größe oder Lesbarkeit der Chunks zu beurteilen.
Bisher bestehen unsere Chunks allerdings hauptsächlich aus Text. Für eine produktive RAG-Pipeline benötigen wir weitere Informationen, beispielsweise die Herkunft eines Chunks und seine Position im Quelldokument.
Im nächsten Experiment erweitern wir unsere Chunks deshalb um Metadaten.
2.8 Ein Chunk ist mehr als Text
In unseren bisherigen Experimenten haben wir Chunks hauptsächlich als Textabschnitte betrachtet. Für das Retrieval reicht das zunächst aus: Wir erzeugen Embeddings und suchen nach semantisch ähnlichen Inhalten.
In einer realen RAG-Anwendung benötigen wir jedoch mehr als den reinen Text.
Wenn unser Retriever einen relevanten Abschnitt findet, möchten wir beispielsweise wissen:
- Aus welchem Dokument stammt der Chunk?
- Wo befindet sich das Quelldokument?
- Zu welchem Abschnitt gehört der gefundene Text?
- An welcher Position im Dokument liegt der Chunk?
Diese zusätzlichen Informationen bezeichnen wir als Metadaten.
Sie helfen uns, Retrieval-Ergebnisse nachzuvollziehen, Quellen anzugeben und später gezielt nach bestimmten Dokumenten zu suchen.
Experiment 2.07: Chunks mit Metadaten modellieren
Wir erweitern unsere bisherige Darstellung und modellieren einen Chunk als eigenes Python-Objekt.
Das Experiment befindet sich in 07_chunk_metadata.py.
Aufruf:
Für solche strukturierten Daten eignet sich eine dataclass aus der Python-Standardbibliothek.
from dataclasses import dataclass


@dataclass
class Chunk:
    """Represents a text chunk with its document metadata."""

    document_id: str
    chunk_number: int
    source: str
    headings: list[str]
    text: str
Der Dekorator @dataclass erzeugt unter anderem automatisch einen Konstruktor für die angegebenen Attribute. Wir müssen deshalb keine eigene __init__()-Methode schreiben.
Unsere Klasse besitzt fünf Felder:
| Attribut | Bedeutung |
|---|---|
document_id |
Eindeutige Kennung des Quelldokuments |
chunk_number |
Position des Chunks innerhalb des Dokuments |
source |
Pfad zur Quelldatei |
headings |
Überschriftenhierarchie des Abschnitts |
text |
Eigentliches Textfragment |
Die Typannotationen beschreiben die erwarteten Datentypen. Sie erzwingen allerdings keine automatische Validierung zur Laufzeit.
Das Ergebnis
Unser Experiment zeigt einen Chunk aus dem Dokument D022.md.
Die Metadaten sehen folgendermaßen aus:
Document: D022
Chunk: 2
Source: data/teralune-rag-corpus/corpus/public/D022.md
Headings: Pagination and cursors > Cursor traversal > Cursor validity
Dazu gehört der eigentliche Textinhalt:
Wir haben damit eine strukturierte Retrieval-Einheit, die sowohl ihren Inhalt als auch ihre Herkunft beschreibt.
Die interne Struktur lässt sich folgendermaßen darstellen:
Der entscheidende Unterschied zu unseren bisherigen Experimenten besteht darin, dass wir nicht mehr ausschließlich Strings verarbeiten.
Ein Chunk ist jetzt ein Objekt mit definierten Eigenschaften.
Warum wir Text und Metadaten unterscheiden
Der Text enthält die Information, nach der wir suchen und die wir später an ein Sprachmodell übergeben können.
Die Metadaten erfüllen andere Aufgaben.
Quellenangaben: Über source und document_id können wir nachvollziehen, aus welchem Dokument eine Information stammt.
Navigation: Mit headings und chunk_number lässt sich ein Treffer innerhalb des ursprünglichen Dokuments einordnen.
Filterung: Metadaten können später verwendet werden, um die Suche auf bestimmte Dokumente oder Dokumentgruppen einzuschränken.
Dafür könnten wir unser Datenmodell beispielsweise um Produktversionen, Dokumenttypen oder Zugriffsrechte erweitern.
Ein RAG-System könnte dann ausschließlich Chunks berücksichtigen, die zur gewünschten Produktversion gehören oder für einen bestimmten Benutzer zugänglich sind.
Solche Filter sind besonders bei Unternehmensdokumenten wichtig.
Welche Informationen gehören in das Embedding?
Nicht jede Metainformation muss Bestandteil des Textes sein, aus dem wir ein Embedding erzeugen.
Bei unserem strukturorientierten Chunking haben wir den Überschriftenpfad bewusst in den Embedding-Text aufgenommen.
Das ist sinnvoll, weil Überschriften wie Cursor traversal oder Cursor validity fachlichen Kontext liefern und damit die semantische Repräsentation beeinflussen können.
Andere Informationen erfüllen dagegen hauptsächlich organisatorische Aufgaben.
Ein Dateipfad oder eine interne Dokumentkennung verbessert nicht zwangsläufig die semantische Bedeutung eines Chunks.
Zugriffsrechte sollten ebenfalls nicht allein über semantische Ähnlichkeit berücksichtigt werden. Sie müssen bei der Auswahl zulässiger Dokumente zuverlässig durchgesetzt werden.
Metadaten und Embeddings
Metadaten speichern und Metadaten in den Embedding-Text aufnehmen sind zwei unterschiedliche Entscheidungen.
Wir können beispielsweise den Dokumentpfad als Metadatum speichern, ohne ihn an das Embedding-Modell zu übergeben.
Umgekehrt können wir den Überschriftenpfad sowohl als Metadatum speichern als auch in den Embedding-Text aufnehmen, wenn er zusätzlichen semantischen Kontext liefert.
Welche Informationen wir einbetten, sollte sich danach richten, ob sie für die spätere Suche tatsächlich hilfreich sind.
Was wir aus dem Experiment mitnehmen
Mit unserer Chunk-Dataclass besitzen wir erstmals eine strukturierte interne Repräsentation unserer Retrieval-Einheiten.
Jeder Chunk enthält seinen Text und die wichtigsten Informationen über seine Herkunft und Position im Dokument.
Diese Trennung bildet eine wichtige Grundlage für spätere Funktionen wie Quellenangaben, Metadatenfilter und Zugriffskontrollen.
Bisher stammen unsere Inhalte allerdings ausschließlich aus Markdown-Dateien.
Im nächsten Experiment untersuchen wir deshalb, wie wir Informationen aus CSV, HTML, DOCX und PDF gewinnen können und welche Schwierigkeiten dabei entstehen.
2.9 Markdown, HTML, CSV, DOCX und PDF
Bisher haben wir ausschließlich Markdown-Dokumente verarbeitet. In der Praxis liegen Unternehmensinformationen jedoch in unterschiedlichen Dateiformaten vor.
Bevor wir solche Dokumente für RAG verwenden können, müssen wir ihre Inhalte extrahieren und in eine gemeinsame Darstellung überführen.
Das Ziel besteht dabei nicht darin, einen universellen Dokumentkonverter selbst zu entwickeln. Wir wollen verstehen, welche Informationen bei der Textextraktion erhalten bleiben und welche verloren gehen können.
Experiment 2.08: Unterschiedliche Dateiformate einlesen
Für unser Experiment verwenden wir vier Dokumente:
| Dokument | Format | Inhalt |
|---|---|---|
D007.csv |
CSV | Produktpläne und ihre Limits |
D020.html |
HTML | Measurement-Schema |
D027.docx |
DOCX | Checkliste für Webhook-Empfänger |
D031.pdf |
Änderungen an Aufbewahrungsrichtlinien |
Das Experiment befindet sich in 08_parse_file_formats.py.
Aufruf:
Die Verarbeitung folgt einem gemeinsamen Prinzip:
Unabhängig vom ursprünglichen Format möchten wir nach der Textextraktion mit einer einheitlichen Python-Datenstruktur weiterarbeiten.
Eine gemeinsame Dokumentrepräsentation
Dafür verwenden wir eine weitere dataclass:
@dataclass
class Document:
    """Represents a loaded document with its source and content."""

    document_id: str
    source: str
    text: str
Die Klasse enthält drei Informationen: die Dokumentkennung, den Pfad zur Quelldatei und den extrahierten Text.
Die formatspezifischen Unterschiede behandeln wir in separaten Loader-Funktionen:
def load_csv(path: Path) -> Document:
    ...

def load_html(path: Path) -> Document:
    ...

def load_docx(path: Path) -> Document:
    ...

def load_pdf(path: Path) -> Document:
    ...
Für CSV genügt die Python-Standardbibliothek. HTML verarbeiten wir mit Beautiful Soup, DOCX mit python-docx und PDF mit pypdf.
Entscheidend ist nun nicht nur, ob die Bibliotheken Text liefern. Wir müssen auch prüfen, was bei der Extraktion mit der ursprünglichen Dokumentstruktur passiert.
CSV: Tabellenbeziehungen erhalten
Unser erstes Dokument ist D007.csv. Es enthält Produktpläne und die zugehörigen Limits.
Die Ausgabe unseres Experiments lautet:
Document: D007
Format: .csv
Characters: 153

plan | devices_per_organization | retention_days | workspaces_per_organization
Starter | 100 | 90 | 1
Team | 1000 | 180 | 5
Enterprise | 10000 | 365 | 20
Die Transformation funktioniert für diese kleine Tabelle gut.
Jede Zeile enthält weiterhin einen vollständigen Datensatz. Die Spaltenreihenfolge bleibt erhalten und die Werte lassen sich den Spaltenüberschriften zuordnen.
Beispielsweise können wir erkennen, dass der Plan Team eine Aufbewahrungsdauer von 180 Tagen besitzt.
Allerdings hängt diese Verständlichkeit davon ab, dass die Spaltenüberschriften erhalten bleiben. Würden wir nur die Datenzeilen extrahieren, wären die Zahlen ohne zusätzlichen Kontext kaum interpretierbar.
Für RAG ist deshalb wichtig, Tabellen nicht einfach in voneinander unabhängige Werte zu zerlegen.
HTML: Text vorhanden, Tabellenstruktur verloren
Das Dokument D020.html beschreibt unter anderem die Felder eines Measurement-Schemas.
Für die Textextraktion verwenden wir Beautiful Soup. Der entscheidende Aufruf lautet:
Damit gewinnen wir den sichtbaren Text aus dem HTML-Dokument. Die HTML-Elemente selbst werden dabei nicht als strukturierte Objekte übernommen.
Unsere Ausgabe enthält unter anderem:
Measurement fields
field
meaning
device_id
registered device identifier
timestamp
RFC 3339 with explicit offset
name
measurement series identifier
value
finite JSON number
unit
stable unit label
Die einzelnen Informationen sind weiterhin vorhanden.
Allerdings war dieser Inhalt ursprünglich als HTML-Tabelle strukturiert. Die Beziehung zwischen einer Tabellenzelle und ihrer Spaltenüberschrift wurde durch die einfache Textextraktion abgeschwächt.
Aus einer Zuordnung wie:
field       meaning
----------- --------------------------------
device_id   registered device identifier
timestamp   RFC 3339 with explicit offset
ist eine Folge einzelner Textzeilen geworden.
Ein Mensch kann die Beziehungen noch rekonstruieren. Für eine automatische Verarbeitung ist das jedoch nicht selbstverständlich.
Ein besserer HTML-Loader könnte Tabellen deshalb gezielt erkennen und beispielsweise als Markdown-Tabellen ausgeben.
DOCX: Gut lesbarer Fließtext
Unser nächstes Dokument ist D027.docx, eine Checkliste für die Integration eines Webhook-Empfängers.
Mit python-docx können wir auf die Absätze eines Word-Dokuments zugreifen.
Unsere Ausgabe beginnt mit:
Document: D027
Format: .docx
Characters: 4277

Webhook receiver checklist
Scope of the receiver handover
This checklist applies to the org-amber receiver integration.
Identify the subscription owner, queue owner and deployment owner
before enabling production deliveries.
Für dieses Dokument funktioniert die Extraktion gut. Der Fließtext ist lesbar und die Reihenfolge der Absätze bleibt erhalten.
Das bedeutet allerdings nicht, dass jedes DOCX so einfach verarbeitet werden kann.
Word-Dokumente können Tabellen, Listen, eingebettete Objekte und unterschiedliche Formatvorlagen enthalten. Eine reine Verarbeitung der Absätze bildet diese Struktur nicht vollständig ab.
Insbesondere Überschriften sind interessant: In einem DOCX werden sie häufig über Formatvorlagen gekennzeichnet. Wenn wir lediglich den Absatztext extrahieren, verlieren wir diese Information.
Für strukturorientiertes Chunking müssten wir deshalb zusätzlich die Formatvorlagen auswerten.
PDF: Textextraktion und Layoutartefakte
Besonders interessant ist unser PDF-Dokument D031.pdf.
Mit pypdf extrahieren wir den Text der einzelnen Seiten.
Das Ergebnis beginnt folgendermaßen:
Document: D031
Format: .pdf
Characters: 1891

Teralune Orbit | D031
Page 1

Retention changes
Change the workspace policy
Retention changes apply at the workspace level.
New workspaces inherit the selected plan policy;
upgrades of the product generation do not silently
replace an existing workspace setting.
Der eigentliche Inhalt ist vorhanden.
Allerdings enthält der extrahierte Text auch Elemente des Seitenlayouts:
Auf der nächsten Seite erscheinen diese Informationen erneut:
Für das PDF sind diese Elemente Kopfzeilen und Seiteninformationen. Nach der Textextraktion sind sie Bestandteil unseres linearen Textes.
Wenn wir diesen Text unverändert chunken, können wiederholte Kopfzeilen in mehreren Chunks landen und deren Embeddings beeinflussen.
Hinzu kommt ein grundsätzliches Problem: Die visuelle Reihenfolge eines PDF-Dokuments entspricht nicht immer der Reihenfolge des extrahierten Textes.
Bei mehrspaltigen Dokumenten, Tabellen oder komplexen Layouts kann die Textextraktion Inhalte in einer ungünstigen Reihenfolge liefern.
Außerdem kann eine Seitengrenze mitten durch einen fachlichen Zusammenhang verlaufen.
Textextraktion ist nicht gleich Dokumentverständnis
Eine Bibliothek kann den Text eines Dokuments technisch korrekt extrahieren, ohne dessen ursprüngliche Struktur vollständig zu erhalten.
Besonders bei Tabellen, mehrspaltigen PDFs und komplex formatierten Word-Dokumenten sollten wir deshalb prüfen, ob die extrahierten Informationen noch verständlich und fachlich korrekt zugeordnet sind.
Normalisierung zwischen Parsing und Chunking
Unsere vier Beispiele zeigen, dass erfolgreiche Textextraktion allein noch keine gute Grundlage für RAG garantiert.
Je nach Dateiformat können Informationen verloren gehen oder zusätzliche Bestandteile im Text erscheinen, die für die eigentliche Wissensbasis keine Bedeutung haben.
Deshalb enthalten produktive Dokumentpipelines häufig einen zusätzlichen Verarbeitungsschritt: die Normalisierung.
Zur Normalisierung können beispielsweise folgende Aufgaben gehören:
- Wiederholte Kopf- und Fußzeilen aus PDFs entfernen.
- Tabellen in eine verständliche Textdarstellung überführen.
- Überschriften und ihre Hierarchie erhalten.
- Überflüssige Leerzeichen und Layoutartefakte bereinigen.
- Dokumentmetadaten vereinheitlichen.
Welche Schritte notwendig sind, hängt vom Dokumentbestand ab.
Eine universelle Lösung gibt es nicht. Insbesondere komplexe PDFs können spezialisierte Parser oder eine zusätzliche layoutbasierte Verarbeitung erfordern.
Was wir aus dem Experiment mitnehmen
Wir haben vier unterschiedliche Dateiformate verarbeitet und ihre Inhalte in eine gemeinsame Document-Struktur überführt.
Dabei haben wir gesehen, dass die reine Textextraktion häufig unkompliziert ist, die Erhaltung der Dokumentstruktur dagegen eine eigenständige Herausforderung darstellt.
CSV ließ sich in unserem Beispiel gut in eine lesbare Tabelle überführen. Bei HTML ging die explizite Tabellenstruktur verloren. DOCX lieferte gut lesbaren Fließtext, während das PDF zusätzliche Layoutinformationen enthielt.
Für unsere weiteren Experimente bleiben wir bewusst bei Markdown. Dort können wir die Dokumentstruktur zuverlässig nachvollziehen und uns auf Chunking, Retrieval und Antwortgenerierung konzentrieren.
Die Verarbeitung anderer Dateiformate ist damit nicht abgeschlossen. Wir haben lediglich die grundlegenden Verfahren und ihre Grenzen kennengelernt.
Im nächsten Experiment schließen wir den Kreis: Wir verbinden Dokumentverarbeitung, Chunking, Embeddings, Retrieval und Antwortgenerierung zu einer vollständigen RAG-Pipeline.
2.10 Vom Dokument zur RAG-Antwort
Am Ende von Kapitel 1 bestand unser RAG-System aus fünf vorbereiteten Sätzen. Wir konnten eine Frage stellen, den passenden Text finden und daraus eine Antwort generieren.
Inzwischen haben wir gelernt, vollständige Dokumente einzulesen, ihre Struktur zu erkennen, sie in Chunks zu zerlegen und diese mit Metadaten zu versehen.
Jetzt verbinden wir diese Bausteine zu einer vollständigen RAG-Pipeline.
Diesmal soll unser System eine Frage beantworten, deren benötigte Informationen in zwei unterschiedlichen Dokumenten stehen.
Experiment 2.09: RAG mit mehreren Dokumenten
Unsere Frage lautet:
The reader paused for 20 minutes. What are the lifetimes of the cursor
and the Orbit 3 token, and is renewing the token enough to continue?
Ein Client hat seine Verarbeitung also für 20 Minuten unterbrochen. Wir möchten wissen, wie lange ein Pagination-Cursor und ein Orbit-3.0-Zugriffstoken gültig sind und ob die Erneuerung des Tokens ausreicht, um die Verarbeitung fortzusetzen.
Für eine vollständige Antwort benötigen wir zwei Informationen:
| Dokument | Benötigte Information |
|---|---|
D022.md |
Gültigkeitsdauer eines Pagination-Cursors |
D002.md |
Gültigkeitsdauer eines Orbit-3.0-Zugriffstokens |
Zusätzlich müssen wir klären, ob die Erneuerung eines Zugriffstokens auch einen abgelaufenen Cursor erneuert.
Das Experiment befindet sich in 09_rag_with_documents.py.
Aufruf:
Zwei Dokumente als Wissensbasis
Wir verwenden die beiden Markdown-Dateien:
DOCUMENT_FILES: list[Path] = [
    CORPUS_DIR / "public" / "D002.md",
    CORPUS_DIR / "public" / "D022.md",
]
Beide Dokumente werden eingelesen und mit unserer strukturorientierten Chunking-Strategie verarbeitet.
Dabei entstehen insgesamt acht Chunks.
Jeder Chunk enthält seinen Text und die Metadaten, die wir im vorherigen Experiment eingeführt haben.
Für die Embeddings kombinieren wir den eigentlichen Inhalt mit dem Überschriftenpfad:
def embedding_text(chunk: Chunk) -> str:
    """Builds the text used to embed a chunk."""
    heading_path: str = " > ".join(chunk.headings)
    return f"{heading_path}\n\n{chunk.text}"
Damit fließt der strukturelle Kontext in die semantische Repräsentation ein.
Ein Chunk über die Gültigkeit eines Cursors wird also nicht nur anhand seines Fließtextes eingebettet. Das Embedding berücksichtigt auch Überschriften wie Pagination and cursors und Cursor validity.
Retrieval: Die relevanten Chunks finden
Wie in Kapitel 1 erzeugen wir ein Embedding der Benutzerfrage und vergleichen es mit den Embeddings unserer Chunks.
Die Ähnlichkeit berechnen wir erneut mit der Kosinusähnlichkeit.
Für die Ergebnisse führen wir eine weitere dataclass ein:
@dataclass
class RetrievalResult:
    """Represents a retrieved chunk and its similarity score."""

    chunk: Chunk
    score: float
Die Klasse verbindet einen gefundenen Chunk mit seinem Ähnlichkeitswert.
Diese Trennung ist wichtig: Der Chunk gehört zu unserem Wissensbestand. Sein score entsteht dagegen erst bei einer konkreten Suchanfrage.
Derselbe Chunk kann bei unterschiedlichen Fragen völlig unterschiedliche Ähnlichkeitswerte erreichen.
Unser Retriever soll die drei besten Treffer zurückgeben:
Das Ergebnis: Beide Dokumente werden gefunden
Der tatsächliche Laborlauf beginnt mit:
Question: The reader paused for 20 minutes. What are the lifetimes of the cursor and the Orbit 3 token, and is renewing the token enough to continue?
Documents: 2
Chunks: 8
Anschließend zeigt das Programm die drei besten Retrieval-Treffer.
Treffer 1: Cursor-Gültigkeit aus D022
1. D022 | score=0.6269
Headings: Pagination and cursors > Cursor traversal > Cursor validity

A cursor expires after 15 minutes and is bound to workspace,
filters and sort order. An expired cursor requires a new traversal.
Weiter unten im selben Chunk steht:
A cursor lifetime is separate from the OAuth token lifetime:
renewing a token does not renew a cursor.
Dieser Treffer enthält zwei entscheidende Informationen.
Ein Cursor läuft nach 15 Minuten ab. Außerdem führt die Erneuerung eines OAuth-Tokens nicht dazu, dass ein abgelaufener Cursor wieder gültig wird.
Treffer 2: Token-Gültigkeit aus D002
2. D002 | score=0.4624
Headings: OAuth and API Keys > Machine credentials

Orbit supports OAuth2 client_credentials for service accounts
and scoped API keys for small integrations. Obtain an access token
at /oauth/token. An Orbit 3.0 access token lasts 60 minutes.
Damit kennen wir auch die Gültigkeitsdauer des Zugriffstokens: 60 Minuten.
Treffer 3: Weitere Authentifizierungsinformationen aus D002
Dieser Abschnitt beschreibt unter anderem die Prüfung von Token-Claims und benötigten Berechtigungen.
Er ist thematisch verwandt, enthält aber keine zusätzliche Information, die wir für unsere konkrete Frage benötigen.
Das ist ein typisches Retrieval-Ergebnis: Nicht jeder gefundene Chunk muss für die Antwort gleichermaßen wichtig sein.
Entscheidend ist, dass die beiden benötigten Informationen unter den besten Treffern liegen.
Aus den Treffern einen Kontext erzeugen
Wir übergeben die gefundenen Chunks nicht einzeln an das Sprachmodell, sondern fassen sie zu einem gemeinsamen Kontext zusammen.
Dabei ergänzen wir jeden Textabschnitt um seine Dokumentkennung und den Überschriftenpfad:
context: str = "\n\n".join(
    (
        f"Source: {result.chunk.document_id}\n"
        f"Section: {' > '.join(result.chunk.headings)}\n"
        f"{result.chunk.text}"
    )
    for result in results
)
Das Ergebnis enthält für jeden Treffer drei Bestandteile:
Source: D022
Section: Pagination and cursors > Cursor traversal > Cursor validity

A cursor expires after 15 minutes ...
Diese Struktur erfüllt zwei Aufgaben.
Erstens erhält das Sprachmodell die fachlichen Informationen, die es für die Antwort benötigt.
Zweitens kann es erkennen, aus welchem Dokument die jeweilige Aussage stammt.
Damit schaffen wir die Voraussetzung für eine Antwort mit Quellenangaben.
Die Antwort generieren
Den zusammengestellten Kontext übergeben wir an das Sprachmodell.
Unser Generator verwendet die OpenAI Responses API:
response = client.responses.create(
    model="gpt-4.1-mini",
    instructions=(
        "Answer the user's question using only the provided context. "
        "If the context is insufficient, say so. "
        "Mention the source document IDs that support the answer."
    ),
    input=f"Context:\n{context}\n\nQuestion:\n{QUESTION}",
)
Die Anweisung enthält drei wesentliche Vorgaben:
- Das Modell soll ausschließlich die bereitgestellten Informationen verwenden.
- Wenn der Kontext nicht ausreicht, soll es das ausdrücklich sagen.
- Es soll die Dokumentkennungen nennen, auf denen seine Antwort beruht.
Die zweite Vorgabe ist besonders wichtig. Ein RAG-System sollte fehlende Informationen nicht durch plausible Vermutungen ersetzen.
Allerdings ist eine solche Anweisung allein keine technische Garantie dafür, dass das Modell ausschließlich belegte Aussagen erzeugt. Die tatsächliche Quellenbindung müssen wir später überprüfen.
Die tatsächliche RAG-Antwort
Unser Laborlauf liefert folgende Antwort:
The cursor lifetime is 15 minutes, and the Orbit 3.0 access token
lifetime is 60 minutes. Since the reader paused for 20 minutes—longer
than the cursor lifetime—the cursor will have expired and requires
a new traversal. Renewing the OAuth token alone is not enough to
continue because renewing a token does not renew a cursor; a new
cursor must be obtained.

(Source: D022 - Cursor validity, D002 - OAuth and API Keys)
Die Antwort kombiniert die Informationen aus beiden Dokumenten korrekt.
Der Cursor ist nach 15 Minuten abgelaufen. Nach einer Unterbrechung von 20 Minuten kann er deshalb nicht weiterverwendet werden.
Das Zugriffstoken besitzt dagegen eine Gültigkeitsdauer von 60 Minuten. Allein aufgrund der beschriebenen Unterbrechung ist es also noch nicht abgelaufen.
Entscheidend ist jedoch, dass beide Gültigkeitsdauern unabhängig voneinander sind.
Die Erneuerung des Zugriffstokens verlängert nicht die Lebensdauer des Cursors.
Der Client muss deshalb eine neue Cursor-Traversierung beginnen.
Unser System nennt außerdem beide Quelldokumente.
Damit haben wir erstmals eine Frage beantwortet, deren Evidenz über mehrere Dokumente verteilt ist.
Unsere vollständige RAG-Pipeline
Gegenüber Kapitel 1 ist unsere Pipeline deutlich realistischer geworden.
flowchart TD
    A["Markdown-Dokumente"] --> B["Einlesen und Parsing"]
    B --> C["Strukturorientiertes Chunking"]
    C --> D["Chunks mit Metadaten"]
    D --> E["Chunk-Embeddings"]

    Q["Benutzerfrage"] --> F["Frage-Embedding"]

    E --> G["Similarity Search"]
    F --> G

    G --> H["Top-k Chunks"]
    H --> I["Kontext mit Quellen"]
    I --> J["Sprachmodell"]
    Q --> J
    J --> K["Antwort mit Quellenangaben"]

    classDef input fill:#DBEAFE,stroke:#2563EB,color:#1E40AF
    classDef processing fill:#DCFCE7,stroke:#16A34A,color:#166534
    classDef retrieval fill:#FFEDD5,stroke:#EA580C,color:#9A3412

    class A,Q input
    class B,C,D,E,F,J processing
    class G,H,I retrieval
    class K input
Die Antwort des Sprachmodells ist dabei nur der letzte Schritt.
Damit sie entstehen konnte, mussten mehrere Voraussetzungen erfüllt sein:
- Die Dokumente mussten korrekt eingelesen werden.
- Die benötigten Informationen mussten in geeigneten Chunks landen.
- Die Chunks mussten ihren fachlichen Kontext behalten.
- Das Embedding-Modell musste Frage und Chunks sinnvoll repräsentieren.
- Das Retrieval musste sowohl
D022als auchD002finden. - Beide Informationen mussten in den Kontext für das Sprachmodell gelangen.
Besonders wichtig ist der fünfte Punkt.
Stellen wir uns vor, unser Retriever hätte ausschließlich Chunks aus D022 gefunden.
Das Sprachmodell hätte dann zwar gewusst, dass der Cursor nach 15 Minuten abläuft. Die Gültigkeitsdauer des Orbit-3.0-Zugriffstokens wäre jedoch nicht im bereitgestellten Kontext enthalten gewesen.
Eine vollständig belegte Antwort wäre damit nicht möglich gewesen.
Generation kann fehlgeschlagenes Retrieval nicht zuverlässig reparieren
Wenn eine benötigte Information nicht im Kontext enthalten ist, kann das Sprachmodell sie nicht zuverlässig aus den gefundenen Quellen ableiten.
Es kann zwar möglicherweise eine plausible Antwort aus seinem vortrainierten Wissen erzeugen. Diese Antwort wäre dann aber nicht durch unsere Retrieval-Ergebnisse belegt.
Deshalb müssen wir Retrieval und Antwortgenerierung als zwei getrennte Qualitätsprobleme betrachten.
Was wir aus dem Experiment mitnehmen
Wir haben erstmals eine vollständige RAG-Pipeline mit mehreren Dokumenten aufgebaut.
Unsere Wissensbasis besteht nicht mehr aus vorbereiteten Beispielsätzen, sondern aus strukturierten Chunks mit Metadaten.
Das Retrieval findet Informationen aus zwei unterschiedlichen Dokumenten. Anschließend kombiniert das Sprachmodell diese Informationen zu einer Antwort und nennt die verwendeten Quellen.
Damit haben wir das zentrale Ziel dieses Kapitels erreicht.
Gleichzeitig besitzt unsere Implementierung noch deutliche Einschränkungen.
Wir erzeugen die Embeddings bei jedem Programmlauf neu, durchsuchen sämtliche Chunks direkt und verwenden keine persistente Datenbank.
Außerdem wissen wir bisher nur, dass unser System diese eine Frage korrekt beantwortet hat.
Welche Probleme bei größeren Dokumentbeständen entstehen und welche Bausteine für ein belastbares RAG-System noch fehlen, betrachten wir im abschließenden Abschnitt.
2.11 Was unser System noch nicht kann
Unser System ist gegenüber dem ersten Kapitel einen großen Schritt weiter.
Wir sind von:
zu:
echten Dokumenten
→ Parsing
→ strukturorientiertem Chunking
→ Metadaten
→ Multi-Document-Retrieval
→ Antwort mit Quellen
gekommen.
Trotzdem ist unser System noch weit von einer produktiven RAG-Anwendung entfernt.
Für das letzte Experiment haben wir genau zwei Dokumente ausgewählt:
DOCUMENT_FILES: list[Path] = [
    CORPUS_DIR / "public" / "D002.md",
    CORPUS_DIR / "public" / "D022.md",
]
Wir wussten bereits, dass die gesuchten Informationen dort enthalten sind.
In einem realen System darf der Retriever diesen Vorteil nicht haben. Er muss die richtigen Chunks aus einem wesentlich größeren Wissensbestand finden.
Außerdem erzeugen wir unsere Embeddings bei jedem Programmlauf neu.
Für acht Chunks ist das kein Problem. Bei Tausenden oder Millionen Chunks wäre dieses Vorgehen unnötig langsam und teuer.
Wir speichern unsere Vektoren auch noch nicht dauerhaft. Stattdessen liegen sie nur während der Programmausführung in Python-Listen.
Weitere Probleme haben wir bisher ebenfalls bewusst ausgeklammert.
Unser Retriever verwendet ausschließlich semantische Ähnlichkeit. Exakte Begriffe, IDs oder Produktcodes können andere Suchverfahren erfordern.
Wir übernehmen schlicht die ersten k Treffer. Wie bereits in Vom Vergleich zum Retrieval gesehen, bedeutet ein Platz im Top-k jedoch nicht automatisch, dass ein Treffer tatsächlich relevant ist.
Wir haben unsere drei Chunking-Strategien außerdem nur anhand einzelner Fragen untersucht. Ob eine Änderung das Gesamtsystem verbessert, können wir erst beurteilen, wenn wir Retrieval systematisch über viele Testfragen messen.
Auch Metadaten werden bisher lediglich mitgeführt. Wir verwenden sie noch nicht, um beispielsweise Produktversionen, Mandanten oder Zugriffsrechte zu filtern.
Und unsere Behandlung von PDF, HTML, CSV und DOCX war bewusst einfach. Produktive Dokumentpipelines müssen abhängig vom Material möglicherweise Tabellen rekonstruieren, wiederholte Kopfzeilen entfernen, Dokumentstruktur erhalten oder andere Normalisierungsschritte durchführen.
Das sind keine Randprobleme.
Sie zeigen vielmehr, dass RAG nicht nur aus einem LLM und einem Vektorvergleich besteht.
Wir bauen eine Informationspipeline:
flowchart LR
    subgraph P1["1. Wissensbasis vorbereiten"]
        direction TB
        A["Dokumente"] --> B["Aufbereitung"]
        B --> C["Retrieval-Einheiten"]
        C --> D["Index"]
    end

    subgraph P2["2. Informationen finden"]
        direction TB
        E["Suche"] --> F["Auswahl"]
        F --> G["Kontext"]
    end

    subgraph P3["3. Antworten und bewerten"]
        direction TB
        H["Generation"] --> I["Evaluation"]
    end

    D --> E
    G --> H

    classDef input fill:#DBEAFE,stroke:#2563EB,color:#1E40AF
    classDef processing fill:#DCFCE7,stroke:#16A34A,color:#166534
    classDef retrieval fill:#FFEDD5,stroke:#EA580C,color:#9A3412
    classDef evaluation fill:#F3E8FF,stroke:#9333EA,color:#6B21A8
    classDef infrastructure fill:#F3F4F6,stroke:#6B7280,color:#374151

    class A input
    class B,C,H processing
    class E,F,G retrieval
    class I evaluation
    class D infrastructure

    style P1 fill:#F8FAFC,stroke:#94A3B8,color:#334155
    style P2 fill:#FFF7ED,stroke:#FDBA74,color:#9A3412
    style P3 fill:#FAF5FF,stroke:#D8B4FE,color:#6B21A8
In diesem Kapitel haben wir uns vor allem mit der ersten Phase unserer Pipeline beschäftigt: der Aufbereitung von Dokumenten und ihrer Zerlegung in geeignete Retrieval-Einheiten.
Wir haben außerdem bereits erste Suchverfahren eingesetzt, allerdings noch ohne einen eigenen Vektorindex.
Im nächsten Kapitel beschäftigen wir uns deshalb damit, wie wir Embeddings effizient speichern und durchsuchen können.
Unsere bisherigen Python-Listen waren dafür ein guter Einstieg. Für größere Wissensbestände benötigen wir jedoch geeignete Datenstrukturen und spezialisierte Werkzeuge.