1 Wie RAG funktioniert
Sprachmodelle können erstaunlich gut erklären, zusammenfassen und formulieren. Sie haben jedoch ein grundlegendes Problem: Sie kennen nicht automatisch die Informationen, die für eine konkrete Anwendung wichtig sind.
Ein internes Handbuch, die aktuelle Produktdokumentation, Support-Tickets oder Unternehmensrichtlinien gehören normalerweise nicht zum Wissen eines Sprachmodells. Selbst wenn ein Modell allgemeines Wissen über ein Produkt besitzt, muss dieses Wissen weder aktuell noch vollständig sein.
Retrieval-Augmented Generation, kurz RAG, verbindet deshalb zwei Aufgaben:
- relevante Informationen finden,
- mit diesen Informationen eine Antwort erzeugen.
In diesem Kapitel bauen wir diese beiden Teile schrittweise selbst auf. Wir beginnen nicht mit einer Vektordatenbank oder einem RAG-Framework, sondern mit wenigen Python-Skripten. Dadurch bleibt sichtbar, was bei einer RAG-Anfrage tatsächlich passiert.
Als Beispiel verwenden wir die Dokumentation des fiktiven Produkts Teralune Orbit. Unsere Wissensbasis besteht zunächst nur aus wenigen kurzen Sätzen.
Am Ende des Kapitels haben wir daraus ein kleines, aber vollständiges RAG-System gebaut.
Unser Praxisbeispiel: Teralune und Orbit
In diesem Buch arbeiten wir mit einem fiktiven Softwareunternehmen namens Teralune. Das Unternehmen entwickelt unter anderem die Softwareplattform Orbit. Ihre technischen Eigenschaften und Produktdokumentationen dienen uns als Beispielwissen für unsere RAG-Systeme.
Eine dieser Eigenschaften betrifft sogenannte Webhooks. Das sind automatische HTTP-Benachrichtigungen, mit denen Anwendungen andere Systeme über Ereignisse informieren. Schlägt eine solche Benachrichtigung fehl, versucht Orbit die Zustellung bis zu 72 Stunden lang erneut.
Wichtig: Teralune, Orbit und Webhooks sind keine Bestandteile von RAG. Sie liefern lediglich die fachlichen Inhalte, mit denen wir die Funktionsweise von RAG untersuchen.
In diesem Kapitel verwenden wir zunächst wenige selbst formulierte Beispielsätze. Später arbeiten wir mit einem umfangreicheren, eigens für dieses Buch entwickelten Dokumentencorpus. Diesen stellen wir in Abschnitt 1.9 genauer vor.
So arbeiten wir mit dem Python-Labor
Dieses Buch wird von einem Python-Labor begleitet. Darin untersuchen wir die einzelnen Bausteine eines RAG-Systems anhand kleiner, ausführbarer Experimente.
In Kapitel 1 befinden sich alle Beispiele im Verzeichnis 01_rag_basics/. Wir beginnen mit der Tokenisierung, erzeugen anschließend Embeddings und entwickeln daraus schrittweise unser erstes RAG-System.
Die Experimente dieses Kapitels
| Skript | Thema | Abschnitt |
|---|---|---|
01_tokens.py |
Text tokenisieren und Token-IDs untersuchen | 1.2 |
02_embedding.py |
Ein Text-Embedding erzeugen | 1.3 |
03_multiple_embeddings.py |
Mehrere Texte in Vektoren umwandeln | 1.4 |
04_cosine_similarity.py |
Ähnlichkeit zwischen Embeddings berechnen | 1.5 |
05_retrieval.py |
Relevante Texte anhand ihrer Embeddings finden | 1.6 |
06_first_rag.py |
Retrieval und Antwortgenerierung verbinden | 1.7 |
Vorbereitung
Die praktischen Übungen zu diesem Buch stehen im frei verfügbaren GitHub-Repository rag-python-lab bereit.
GitHub-Repository öffnen und Python-Beispiele herunterladen
Das Labor verwendet Python und den Paketmanager uv. Alle benötigten Abhängigkeiten sind in der Projektkonfiguration hinterlegt.
Zunächst klonen wir das Repository:
Anschließend wechseln wir in das Projektverzeichnis und installieren die Abhängigkeiten:
Damit ist die Entwicklungsumgebung für die folgenden Übungen vorbereitet.
Die ersten Experimente können vollständig lokal ausgeführt werden. Ab Experiment 1.02 verwenden wir die OpenAI API für die Erzeugung von Embeddings und später für die Antwortgenerierung.
Dafür benötigen wir einen API-Key, den wir in einer .env-Datei im Projektverzeichnis hinterlegen:
Anschließend starten wir die Experimente aus dem Projektverzeichnis, beispielsweise:
Jedes Experiment wird im zugehörigen Buchabschnitt erläutert. Wir betrachten dabei den entscheidenden Python-Code, die Ergebnisse und ihre Bedeutung für unsere RAG-Pipeline.
1.1 Warum ein Sprachmodell externes Wissen braucht
Nehmen wir an, ein Benutzer stellt folgende Frage:
How long does Orbit retry a failed webhook delivery?
Die gesuchte Information befindet sich in unserer Produktdokumentation:
Ein Sprachmodell sollte diese Information nicht erraten müssen. Unsere Anwendung soll zunächst die passende Stelle in der Dokumentation finden und sie anschließend zusammen mit der Frage an das Sprachmodell übergeben.
Das Grundprinzip sieht so aus:
flowchart LR
    Q["Benutzerfrage"]
    R["Retrieval"]
    K["Wissensbasis"]
    C["Gefundene Informationen"]
    L["LLM"]
    A["Antwort"]

    Q --> R
    K --> R
    R --> C
    C --> L
    L --> A

    classDef io fill:#dbeafe,stroke:#2563eb,color:#1e3a8a
    classDef retrieval fill:#fef3c7,stroke:#d97706,color:#78350f
    classDef processing fill:#dcfce7,stroke:#16a34a,color:#14532d

    class Q,A io
    class R,K retrieval
    class C,L processing
In diesem Paper steht mehr zu RAG: https://arxiv.org/abs/2005.11401
Retrieval ist mehr als Vektorsuche
Retrieval bedeutet, relevante Informationen zu finden und bereitzustellen. Es ist weder auf Embeddings noch auf Vektordatenbanken beschränkt.
Die Informationen können aus unterschiedlichen Quellen stammen:
- Textdokumente: Handbücher, Webseiten, Support-Tickets oder technische Dokumentation.
- Strukturierte Daten: Relationale Datenbanken, Tabellen oder API-Antworten.
- Bilder und multimodale Inhalte: Diagramme, Screenshots oder Dokumente mit Text und Bildern.
Auch die Suchverfahren unterscheiden sich. Eine Volltextsuche findet beispielsweise passende Begriffe, eine SQL-Abfrage selektiert strukturierte Datensätze und eine semantische Vektorsuche findet Texte anhand ihrer inhaltlichen Ähnlichkeit.
In komplexeren RAG-Systemen werden mehrere dieser Verfahren kombiniert.
Für unser erstes RAG-System konzentrieren wir uns auf die semantische Suche in Texten. Dafür benötigen wir Embeddings, also numerische Repräsentationen von Textinhalten.
Damit haben wir die Aufgabe des Retrievals eingegrenzt: Wir wollen zu einer Benutzerfrage passende Textstellen finden. Wie wir diese Textstellen anschließend für eine Antwort verwenden, untersuchen wir im weiteren Verlauf des Kapitels.
Bevor wir Embeddings erzeugen und vergleichen, müssen wir allerdings verstehen, wie Sprachmodelle Text verarbeiten.
1.2 Text wird zu Token
Sprachmodelle verarbeiten Text nicht unmittelbar als Folge von Wörtern. Bevor ein Modell mit einem Text arbeiten kann, wird dieser in kleinere Einheiten zerlegt, sogenannte Token.
Ein Token kann ein vollständiges Wort, ein Wortbestandteil, ein Satzzeichen oder eine andere Zeichenfolge sein. Anders als Wörter besitzen Token keine allgemeingültigen sprachlichen Grenzen. Wie ein Text zerlegt wird, hängt vom verwendeten Tokenizer ab.
Ein Tokenizer übernimmt dabei zwei Aufgaben: Er zerlegt den Eingabetext nach bestimmten Regeln in Token und ordnet diesen numerische IDs zu. Diese IDs bilden die Grundlage für die weitere Verarbeitung durch das Modell.
Unterschiedliche Tokenisierungsverfahren
Nicht alle Modelle verwenden dieselbe Tokenisierung. Im Laufe der Entwicklung der Sprachverarbeitung haben sich verschiedene Ansätze etabliert:
| Verfahren | Grundprinzip |
|---|---|
| Word-Level | Zerlegt Text in vollständige Wörter. |
| Character-Level | Verwendet einzelne Zeichen als Token. |
| Subword-Level | Zerlegt Wörter bei Bedarf in kleinere Bestandteile. |
| Byte-Pair Encoding (BPE) | Bildet durch wiederholtes Zusammenfassen häufiger Symbolfolgen ein Subword-Vokabular. |
| WordPiece | Subword-Verfahren, das unter anderem bei BERT verwendet wird. |
| Unigram | Wählt Tokenisierungen anhand eines probabilistischen Subword-Modells. |
Die Begriffe bezeichnen nicht alle dieselbe Ebene: Subword-Level beschreibt eine Kategorie von Verfahren, während BPE, WordPiece und Unigram konkrete Verfahren zur Bildung und Auswahl von Token sind.
Daneben gibt es Werkzeuge wie SentencePiece. SentencePiece ist kein eigener Tokentyp, sondern ein Framework, das unter anderem BPE und Unigram unterstützt und direkt mit Rohtext arbeiten kann.
Moderne Sprachmodelle verwenden häufig Subword-Verfahren. Sie ermöglichen es, häufige Wörter kompakt darzustellen und gleichzeitig seltene oder unbekannte Wörter aus kleineren Einheiten zusammenzusetzen.
Daraus folgt eine wichtige Eigenschaft:
Derselbe Text kann je nach Tokenizer in unterschiedlich viele Token zerlegt werden. Auch die zugehörigen Token-IDs sind nicht zwischen verschiedenen Tokenizern übertragbar.
Experiment 1.01: Tokenisierung mit tiktoken
Wir untersuchen nun, wie ein konkreter Tokenizer unseren Beispielsatz verarbeitet.
Experiment ausführen:
Für das Experiment verwenden wir die Python-Bibliothek tiktoken. Sie stellt unter anderem die Tokenizer-Encodings verschiedener OpenAI-Modelle bereit.
Unser Eingabetext lautet:
Wir laden das Encoding o200k_base und lassen den Text tokenisieren:
import tiktoken

text = "Orbit retries failed webhook deliveries for 72 hours."

encoding = tiktoken.get_encoding("o200k_base")
tokens = encoding.encode(text)
get_encoding() lädt die Regeln und das Vokabular des angegebenen Encodings. encode() wandelt den Text anschließend in eine Liste numerischer Token-IDs um.
Unser Experiment liefert:
Der Satz besteht mit diesem Tokenizer also aus zehn Token.
Interessanter wird es, wenn wir die einzelnen Token wieder dekodieren:
Die tatsächliche Ausgabe lautet:
124738 -> 'Orbit'
147909 -> ' retries'
  9363 -> ' failed'
160641 -> ' webhook'
 70573 -> ' deliveries'
   395 -> ' for'
   220 -> ' '
  8540 -> '72'
  5123 -> ' hours'
    13 -> '.'
Hier erkennen wir mehrere Eigenschaften der Tokenisierung. Viele Wörter werden jeweils durch ein einzelnes Token repräsentiert. Leerzeichen können Bestandteil eines Tokens sein, und vor 72 ist sogar ein eigenständiges Leerzeichen-Token entstanden.
Ein Token ist also weder zwangsläufig ein vollständiges Wort noch ein einzelnes Zeichen.
Welchen Tokenizer verwenden wir in realen Projekten?
Unser Experiment verwendet o200k_base, ein Encoding mit einem Vokabular von ungefähr 200.000 Token, das für bestimmte OpenAI-Modelle eingesetzt wird.
Das bedeutet allerdings nicht, dass o200k_base für jedes Sprachmodell geeignet ist. Andere Modelle verwenden andere Encodings und können denselben Text unterschiedlich tokenisieren.
Bei unterstützten OpenAI-Modellen können wir den passenden Tokenizer anhand des Modellnamens auswählen:
In einer produktiven Anwendung sollten wir deshalb den Tokenizer verwenden, der zum tatsächlich eingesetzten Modell gehört. Ein beliebig ausgewähltes Encoding kann zu falschen Schätzungen der Token-Anzahl führen.
Außerdem ist zu beachten, dass die Tokenisierung eines einfachen Textstrings nicht zwangsläufig den vollständigen Token-Verbrauch einer API-Anfrage abbildet. Zusätzliche Nachrichtenstrukturen, Tool-Aufrufe oder multimodale Eingaben können weitere Token beziehungsweise modellabhängige Verarbeitungskosten verursachen.
Warum ist Tokenisierung für RAG wichtig?
Die Token-Anzahl beeinflusst mehrere Aspekte unserer späteren RAG-Pipeline:
- Kontextfenster: Sprachmodelle können nur eine begrenzte Menge an Eingabe- und Ausgabekontext verarbeiten.
- Chunking: Bei der Zerlegung längerer Dokumente müssen wir entscheiden, wie groß die einzelnen Textabschnitte sein dürfen.
- API-Kosten: Bei vielen Modellen hängt die Abrechnung unter anderem von der Anzahl verarbeiteter Token ab.
Für unser erstes RAG-System müssen wir die Tokenisierung noch nicht selbst implementieren. Wir sollten aber verstehen, dass die Länge eines Textes in Zeichen oder Wörtern nicht zuverlässig seiner Länge in Token entspricht.
Fazit: Tokenisierung übersetzt Text in diskrete, numerisch identifizierte Einheiten. Welche Einheiten entstehen, hängt vom Tokenizer ab. Für RAG ist das insbesondere dann relevant, wenn wir später Dokumente aufteilen und die verfügbare Kontextlänge eines Sprachmodells berücksichtigen müssen.
Für die semantische Suche benötigen wir allerdings noch eine andere numerische Darstellung: Embeddings.
1.3 Text wird zum Vektor
Im vorherigen Abschnitt haben wir gesehen, wie ein Tokenizer Text in Token zerlegt und diesen numerische IDs zuordnet.
Aber was machen wir jetzt mit diesen Token-IDs?
Eine Token-ID sagt zunächst nur, welches Token gemeint ist. Die Zahl selbst beschreibt nicht die Bedeutung eines Wortes. Aus der ID 124738 können wir beispielsweise nicht ablesen, was „Orbit“ bedeutet.
Für die semantische Suche benötigen wir deshalb eine andere Darstellung: Embeddings.
Ein Embedding ist ein Vektor aus Zahlen, der Informationen über die Bedeutung eines Textes repräsentiert. Damit können wir später untersuchen, welche Texte inhaltlich ähnlich sind.
Wie hängen Token und Embeddings zusammen?
Ein Embedding-Modell verarbeitet Text in mehreren Schritten:
- Tokenisierung: Der Eingabetext wird in Token zerlegt und in Token-IDs umgewandelt.
- Token-Embeddings: Die Token-IDs werden auf gelernte numerische Vektoren abgebildet.
- Kontextverarbeitung: Das Modell verarbeitet die Token gemeinsam und berücksichtigt ihre Beziehungen zueinander.
- Text-Embedding: Aus den verarbeiteten Repräsentationen entsteht ein einzelner Vektor für den gesamten Eingabetext.
Vereinfacht sieht das so aus:
flowchart LR
    subgraph A["1. Tokenisierung"]
        direction LR
        T["Eingabetext"] --> Z["Tokenizer"] --> I["Token-IDs"]
    end

    subgraph B["2. Embedding-Erzeugung"]
        direction LR
        E["Token-Embeddings"] --> M["Modell verarbeitet<br/>den Kontext"] --> V["Text-Embedding"]
    end

    I --> E

    classDef io fill:#dbeafe,stroke:#2563eb,color:#1e3a8a
    classDef processing fill:#dcfce7,stroke:#16a34a,color:#14532d

    class T,V io
    class Z,I,E,M processing
Dabei unterscheiden wir zwei Begriffe:
Token-Embedding: Die numerische Repräsentation eines einzelnen Tokens.
Text-Embedding: Die numerische Repräsentation eines vollständigen Textes, beispielsweise eines Satzes oder Absatzes.
Wie genau das Modell aus den einzelnen Token-Repräsentationen einen gemeinsamen Textvektor erzeugt, hängt von seiner Architektur ab.
Müssen wir den Text selbst tokenisieren?
Nein. Und das ist für unser Experiment wichtig.
In Abschnitt 1.2 haben wir mit tiktoken und o200k_base selbst einen Text tokenisiert. Das war ein eigenständiges Experiment, um die Tokenisierung sichtbar zu machen.
Jetzt verwenden wir das Embedding-Modell text-embedding-3-small.
Dieses Modell übernimmt die notwendige Tokenisierung intern. Wir übergeben ihm deshalb den ursprünglichen Text und nicht die Token-IDs aus dem vorherigen Experiment.
Wir müssen auch nicht sicherstellen, dass unser vorheriges Encoding o200k_base mit dem intern verwendeten Tokenizer des Embedding-Modells übereinstimmt. Die beiden Experimente sind unabhängig voneinander.
Experiment 1.02: Unser erstes Text-Embedding
Wir wollen herausfinden, wie ein Embedding-Modell unseren Beispielsatz numerisch repräsentiert.
Experiment ausführen:
Wir verwenden wieder denselben Text:
Diesmal schicken wir ihn direkt an das Embedding-Modell:
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()

client = OpenAI()

text = "Orbit retries failed webhook deliveries for 72 hours."

response = client.embeddings.create(
    model="text-embedding-3-small",
    input=text,
)

embedding = response.data[0].embedding
load_dotenv() lädt unsere Umgebungsvariablen aus der .env-Datei. Dort haben wir unseren OPENAI_API_KEY hinterlegt.
Anders als tiktoken benötigt dieser API-Aufruf einen gültigen OpenAI API-Key, weil das Embedding-Modell über die API ausgeführt wird.
Mit client.embeddings.create() übergeben wir unseren Text an das Modell. Die API liefert einen Vektor zurück, den wir über response.data[0].embedding auslesen.
Wir erhalten keine Liste von Token-IDs, sondern das fertige Text-Embedding.
Unser Experiment liefert:
Vector dimensions: 1536

First 10 values:
[-0.037384033203125,
 0.02581787109375,
 0.05194091796875,
 -0.00933074951171875,
 -0.027557373046875,
 0.02398681640625,
 0.033355712890625,
 0.048736572265625,
 0.0201568603515625,
 0.0061492919921875]
Aus unserem Satz ist ein Vektor mit 1536 Dimensionen geworden.
Das bedeutet: Der Vektor besteht aus 1536 Zahlen. Wir zeigen hier nur die ersten zehn.
Die einzelnen Werte besitzen keine unmittelbar verständliche Bedeutung. Wir können beispielsweise nicht sagen, dass die vierte Zahl -0.00933074951171875 für „Webhook“ oder „72 Stunden“ steht.
Entscheidend ist vielmehr, wie sich der gesamte Vektor zu den Vektoren anderer Texte verhält.
Warum hilft uns das bei der Suche?
Ein Embedding-Modell wird darauf trainiert, bestimmte semantische Beziehungen zwischen Texten in ihren Vektorrepräsentationen abzubilden.
Unser Ziel ist, dass Texte mit ähnlicher Bedeutung auch ähnliche Vektoren erhalten.
Beispielsweise behandeln diese beiden Sätze dasselbe Thema:
Obwohl sie unterschiedlich formuliert sind, sollten ihre Embeddings eine vergleichsweise hohe Ähnlichkeit besitzen.
Genau das werden wir in den nächsten Experimenten überprüfen.
Fazit: Tokenisierung und Embeddings sind keine konkurrierenden Verfahren. Die Tokenisierung liefert die Eingabeeinheiten für ein Modell. Das Embedding-Modell verarbeitet diese Einheiten und erzeugt daraus einen Vektor, der den gesamten Text repräsentiert.
In unserem Python-Code müssen wir dafür lediglich den Text an das Embedding-Modell übergeben. Die interne Verarbeitung übernimmt das Modell.
Im nächsten Abschnitt erzeugen wir Embeddings für mehrere Texte und betrachten, wie sie sich in einem gemeinsamen Vektorraum darstellen lassen.
1.4 Bedeutung im Vektorraum
Im vorherigen Abschnitt haben wir einen einzelnen Satz mit text-embedding-3-small in einen Vektor mit 1536 Dimensionen umgewandelt.
Ein einzelner Vektor hilft uns bei der Suche allerdings noch nicht weiter. Dafür benötigen wir mehrere Texte, deren Embeddings wir miteinander vergleichen können.
Unser Ziel ist deshalb, mehrere Texte in denselben Vektorraum abzubilden. Anschließend können wir untersuchen, welche Texte sich inhaltlich besonders ähnlich sind.
Experiment 1.03: Mehrere Embeddings erzeugen
Wir erweitern unsere kleine Wissensbasis um zwei weitere Informationen aus unserem fiktiven Teralune-Orbit-Beispiel.
Die drei Texte behandeln unterschiedliche Themen:
texts = [
    "Orbit retries failed webhook deliveries for 72 hours.",
    "Orbit access tokens are valid for 60 minutes.",
    "Orbit retains telemetry data for 90 days.",
]
Der erste Satz beschreibt die Wiederholung fehlgeschlagener Webhook-Zustellungen. Der zweite behandelt die Gültigkeitsdauer von Zugriffstoken und der dritte die Aufbewahrung von Telemetriedaten.
Experiment ausführen:
Wir verwenden wieder text-embedding-3-small. Diesmal übergeben wir dem Modell allerdings eine Liste mit drei Texten:
Das Modell verarbeitet jeden Text separat und liefert für jeden Eintrag einen eigenen Vektor.
Wir können die Ergebnisse gemeinsam mit den ursprünglichen Texten ausgeben:
for text, item in zip(texts, response.data):
    print(text)
    print(f"Dimensions: {len(item.embedding)}")
    print(f"First values: {item.embedding[:5]}")
    print()
response.data enthält die Embedding-Ergebnisse. Mit zip() verbinden wir jeden Eingabetext mit seinem zugehörigen Ergebnis.
Unser Experiment liefert:
Orbit retries failed webhook deliveries for 72 hours.
Dimensions: 1536
First values: [-0.037445068359375, 0.0257720947265625, ...]

Orbit access tokens are valid for 60 minutes.
Dimensions: 1536
First values: [-0.02947998046875, 0.013580322265625, ...]

Orbit retains telemetry data for 90 days.
Dimensions: 1536
First values: [-0.0308685302734375, 0.0210113525390625, ...]
Jeder Text besitzt einen eigenen Vektor mit 1536 Dimensionen.
Was bedeutet ein gemeinsamer Vektorraum?
Weil wir alle drei Texte mit demselben Embedding-Modell verarbeitet haben, liegen ihre Vektoren in einem gemeinsamen mathematischen Raum.
Jeder Vektor beschreibt darin einen Punkt. Die 1536 Zahlen bestimmen seine Position beziehungsweise Richtung.
Das können wir uns vereinfacht wie eine Landkarte vorstellen: Texte mit ähnlichen Bedeutungen sollen näher beieinanderliegen als Texte, die unterschiedliche Themen behandeln.
Unsere drei Texte beschäftigen sich zwar alle mit Orbit, behandeln aber unterschiedliche Aspekte der Plattform.
Die folgende Grafik illustriert diese Idee:
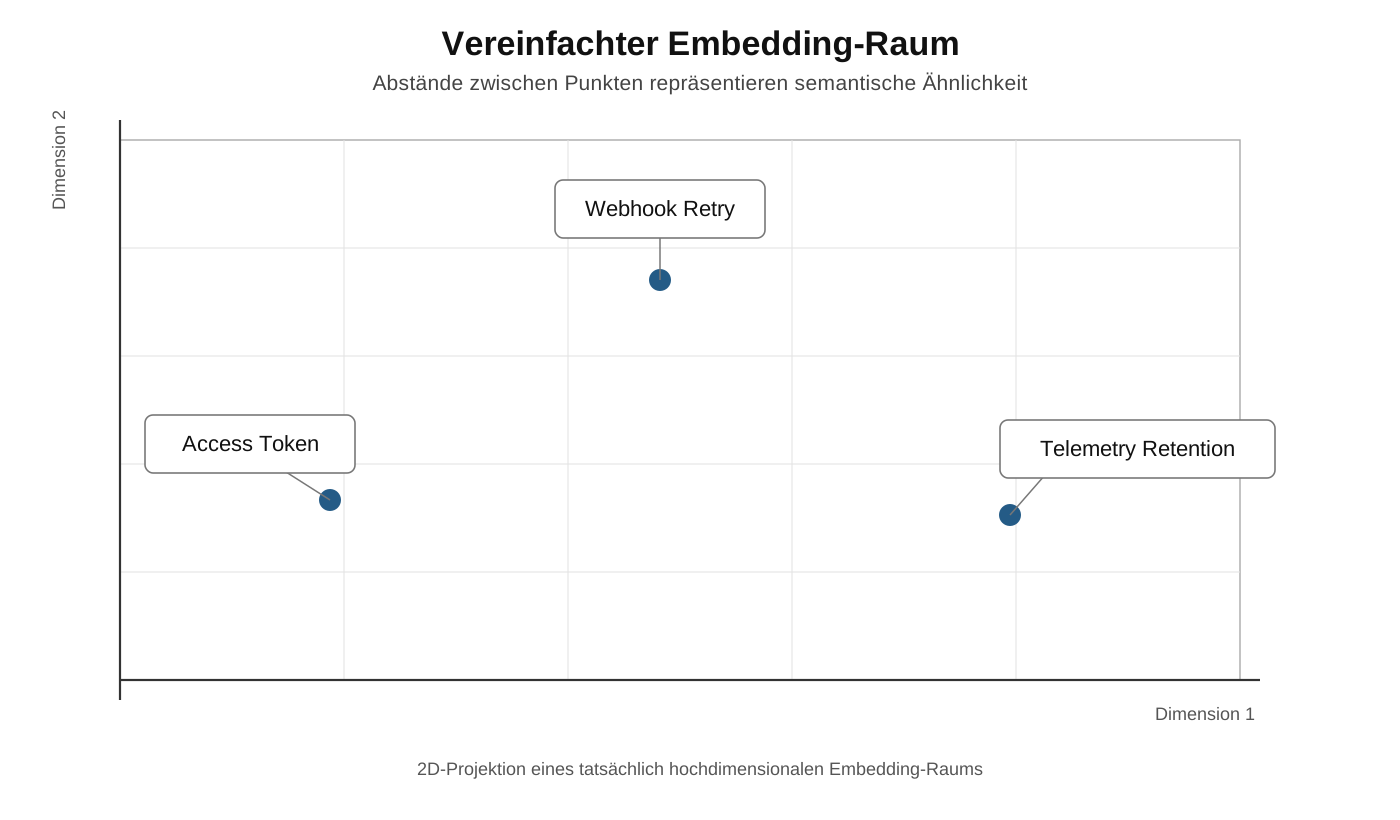
Die Grafik reduziert den Vektorraum auf zwei Dimensionen, damit wir ihn darstellen können. Tatsächlich besitzt unser Embedding-Raum 1536 Dimensionen.
Wichtig ist außerdem: Die Positionen in der Grafik sind eine didaktische Veranschaulichung und keine gemessene Projektion unserer tatsächlichen Embeddings.
Warum ist das für Retrieval wichtig?
Wenn wir eine Benutzerfrage ebenfalls mit text-embedding-3-small in einen Vektor umwandeln, können wir diesen mit den drei Dokumentvektoren vergleichen.
Beispielsweise:
Wir erwarten, dass diese Frage dem Webhook-Text ähnlicher ist als den Informationen über Zugriffstoken oder Telemetriedaten.
Ob das tatsächlich der Fall ist, können wir mathematisch überprüfen.
Fazit: Ein Embedding-Modell ermöglicht es uns, unterschiedliche Texte als Vektoren in einem gemeinsamen Raum darzustellen. Damit schaffen wir die Voraussetzung für eine semantische Suche.
Bisher haben wir allerdings nur Vektoren erzeugt. Im nächsten Abschnitt berechnen wir erstmals ihre Ähnlichkeit und überprüfen, ob unsere Webhook-Frage tatsächlich zum richtigen Dokument führt.
1.5 Ähnlichkeit messen
Bisher haben wir mehrere Texte mit demselben Embedding-Modell in Vektoren umgewandelt. Wir wissen nun, dass diese Vektoren in einem gemeinsamen Raum liegen.
Aber wie stellen wir fest, welche Texte sich inhaltlich am ähnlichsten sind?
Dafür benötigen wir ein mathematisches Ähnlichkeitsmaß. In diesem Experiment verwenden wir die Kosinus-Ähnlichkeit (Cosine Similarity).
Was ist die Kosinus-Ähnlichkeit?
Die Kosinus-Ähnlichkeit misst den Winkel zwischen zwei Vektoren. Genauer gesagt berechnet sie den Kosinus dieses Winkels.
Dabei interessiert uns vor allem die Richtung der Vektoren, nicht ihre Länge.
Für zwei Vektoren $a$ und $b$ lautet die Formel:
$$ \operatorname{cosine}(a,b) = \frac{a \cdot b}{|a| \cdot |b|} $$
Im Zähler steht das Skalarprodukt der beiden Vektoren. Im Nenner steht das Produkt ihrer euklidischen Längen.
Das Ergebnis liegt zwischen −1 und 1:
| Wert | Bedeutung |
|---|---|
| 1 | Beide Vektoren zeigen in dieselbe Richtung. |
| 0 | Die Vektoren stehen senkrecht aufeinander. |
| −1 | Die Vektoren zeigen in entgegengesetzte Richtungen. |
Bei Text-Embeddings verwenden wir die Kosinus-Ähnlichkeit als Indikator für semantische Ähnlichkeit. Je höher der Wert, desto ähnlicher sind die Vektoren hinsichtlich der vom Modell erlernten Repräsentation.
Ein Wert von 0.8 bedeutet allerdings nicht, dass zwei Texte zu 80 Prozent dieselbe Bedeutung besitzen. Die Kosinus-Ähnlichkeit ist keine Prozentangabe.
Experiment 1.04: Welche Information passt zur Frage?
Wir verwenden drei Informationen über unsere fiktive Softwareplattform Orbit:
texts = [
    "Orbit retries failed webhook deliveries for 72 hours.",
    "Orbit access tokens are valid for 60 minutes.",
    "Orbit retains telemetry data for 90 days.",
]
Unsere Benutzerfrage lautet:
Wir erwarten, dass der erste Text am besten zur Frage passt. Schließlich beschreibt er genau die gesuchte Wiederholungsdauer.
Experiment ausführen:
Zunächst erzeugen wir Embeddings für die Frage und die drei Texte. Dafür verwenden wir wieder text-embedding-3-small.
response = client.embeddings.create(
    model="text-embedding-3-small",
    input=[question, *texts],
)

question_embedding = response.data[0].embedding
text_embeddings = [
    item.embedding for item in response.data[1:]
]
Durch [question, *texts] übergeben wir alle vier Eingaben gemeinsam an die API.
Das erste Embedding gehört zur Frage. Die übrigen drei gehören zu unseren Beispieltexten.
Damit können wir die Ähnlichkeit berechnen.
Kosinus-Ähnlichkeit in Python
Die Berechnung lässt sich mit NumPy umsetzen:
import numpy as np


def cosine_similarity(a: list[float], b: list[float]) -> float:
    vector_a = np.array(a)
    vector_b = np.array(b)

    return float(
        np.dot(vector_a, vector_b)
        / (np.linalg.norm(vector_a) * np.linalg.norm(vector_b))
    )
np.dot() berechnet das Skalarprodukt. Mit np.linalg.norm() bestimmen wir die Längen der Vektoren.
Anschließend vergleichen wir das Embedding unserer Frage mit jedem Text-Embedding:
for text, embedding in zip(texts, text_embeddings):
    score = cosine_similarity(question_embedding, embedding)
    print(f"{score:.4f} | {text}")
Unser Experiment liefert folgende Werte:
0.5956 | Orbit retries failed webhook deliveries for 72 hours.
0.3359 | Orbit access tokens are valid for 60 minutes.
0.2812 | Orbit retains telemetry data for 90 days.
Was sagen uns diese Ergebnisse?
Der Webhook-Text erreicht mit 0.5956 den höchsten Ähnlichkeitswert.
Das entspricht unserer Erwartung: Die Frage beschäftigt sich mit der Wiederholung fehlgeschlagener Webhooks, und genau diese Information enthält der erste Text.
Die anderen beiden Texte besitzen ebenfalls positive Ähnlichkeitswerte. Sie gehören zum selben fachlichen Umfeld, beantworten aber eine andere Frage.
Entscheidend ist hier deshalb weniger der absolute Wert als die Reihenfolge der Ergebnisse.
Wir können die drei Texte anhand ihrer Ähnlichkeit sortieren und den besten Treffer auswählen.
Damit haben wir bereits den mathematischen Kern einer einfachen semantischen Suche kennengelernt.
Was die Kosinus-Ähnlichkeit nicht leisten kann
Die Kosinus-Ähnlichkeit sagt uns, wie ähnlich sich zwei Vektoren sind. Sie überprüft aber nicht, ob ein Text tatsächlich eine korrekte Antwort enthält.
Ein Dokument könnte beispielsweise viele Begriffe aus unserer Frage enthalten und trotzdem veraltete oder falsche Informationen liefern.
Außerdem erhält auch ein unpassender Text einen Ähnlichkeitswert. Die Berechnung allein entscheidet nicht, ob ein Treffer relevant genug ist, um verwendet zu werden.
Fazit: Mit der Kosinus-Ähnlichkeit können wir eine Benutzerfrage und mehrere Texte anhand ihrer Embeddings vergleichen. In unserem Experiment erhält die fachlich passende Information den höchsten Wert.
Im nächsten Abschnitt machen wir daraus einen einfachen Retrieval-Prozess: Wir vergleichen eine Frage mit mehreren Dokumenten, sortieren die Ergebnisse und wählen die relevantesten Treffer aus.
1.6 Vom Vergleich zum Retrieval
Im vorherigen Experiment haben wir die Kosinus-Ähnlichkeit zwischen einer Benutzerfrage und drei Texten berechnet. Der passende Webhook-Text erhielt dabei den höchsten Wert.
Für ein Retrieval-System reicht es allerdings nicht, Ähnlichkeitswerte zu berechnen. Wir müssen die gefundenen Texte auch nach ihrer Relevanz sortieren und entscheiden, welche davon wir verwenden wollen.
Diesen Vorgang bezeichnen wir als Retrieval.
Experiment 1.05: Die relevantesten Texte finden
Wir erweitern unsere kleine Wissensbasis auf fünf Texte und stellen eine neue Frage:
Das Ziel ist, die Texte zu finden, die am besten zu dieser Frage passen.
Experiment ausführen:
Wie bisher erzeugen wir mit text-embedding-3-small Embeddings für die Frage und die vorhandenen Texte.
Anschließend berechnen wir für jeden Text die Kosinus-Ähnlichkeit zur Frage.
Der entscheidende neue Schritt besteht darin, die Ergebnisse zu sortieren:
Jeder Eintrag enthält einen Ähnlichkeitswert und den zugehörigen Text. Mit reverse=True stehen die höchsten Werte zuerst.
Nun wählen wir die drei besten Treffer aus:
Der Parameter top_k bestimmt, wie viele Treffer wir zurückgeben.
Unser Experiment liefert:
0.5613 | Orbit retries failed webhook deliveries for 72 hours.
0.1738 | Orbit API requests are limited to 1000 per minute.
0.1567 | Orbit access tokens are valid for 60 minutes.
Was haben wir gefunden?
Der erste Treffer passt zur Frage: Wenn eine Webhook-Zustellung fehlschlägt, versucht Orbit die Zustellung bis zu 72 Stunden lang erneut.
Die beiden anderen Treffer behandeln dagegen API-Limits und Zugriffstoken. Sie gehören zwar zur technischen Dokumentation von Orbit, beantworten unsere Frage aber nicht.
Hier zeigt sich eine wichtige Eigenschaft unseres einfachen Retrieval-Verfahrens:
Top-k liefert die k ähnlichsten Texte, nicht zwangsläufig k relevante Texte.
Wenn wir drei Treffer anfordern, erhalten wir drei Treffer, auch wenn nur einer davon tatsächlich hilfreich ist.
Das ist zunächst kein Fehler der Implementierung. Wir haben unserem Retrieval-System lediglich gesagt, dass es die drei ähnlichsten Texte zurückgeben soll. Eine Mindestanforderung an ihre Relevanz haben wir noch nicht definiert.
Später werden wir deshalb untersuchen, wie wir die Qualität der Treffer verbessern und ungeeignete Ergebnisse herausfiltern können.
Vom Retrieval zur Antwort
Unser Programm kann jetzt eine Benutzerfrage entgegennehmen und passende Informationen aus einer kleinen Wissensbasis auswählen.
Was es noch nicht kann, ist eine Antwort formulieren.
Bisher sieht unser Ablauf so aus:
flowchart LR
    Q["Benutzerfrage"]
    E["Embedding erzeugen"]
    S["Ähnlichkeiten berechnen"]
    R["Treffer sortieren"]
    K["Top-k-Texte auswählen"]

    Q --> E --> S --> R --> K

    classDef io fill:#dbeafe,stroke:#2563eb,color:#1e3a8a
    classDef retrieval fill:#fef3c7,stroke:#d97706,color:#78350f
    classDef processing fill:#dcfce7,stroke:#16a34a,color:#14532d

    class Q io
    class E processing
    class S,R,K retrieval
Wir haben damit den Retrieval-Teil unserer ersten RAG-Pipeline umgesetzt.
Fazit: Retrieval vergleicht eine Frage mit vorhandenen Texten, sortiert die Ergebnisse und wählt die besten Treffer aus. Die Top-k-Auswahl garantiert allerdings nicht, dass alle zurückgegebenen Texte relevant sind.
Im nächsten Abschnitt übergeben wir diese Treffer erstmals an ein Sprachmodell. Damit verbinden wir Retrieval und Generation zu unserem ersten vollständigen RAG-System.
1.7 Das erste RAG-System
In den bisherigen Experimenten haben wir die einzelnen Bausteine unserer RAG-Pipeline kennengelernt. Wir können Texte in Embeddings umwandeln, ihre Ähnlichkeit mit einer Benutzerfrage berechnen und die relevantesten Informationen aus unserer kleinen Wissensbasis auswählen.
Was bisher fehlt, ist die eigentliche Antwortgenerierung.
Genau diesen letzten Schritt ergänzen wir jetzt. Wir übergeben die gefundenen Texte zusammen mit der Benutzerfrage an ein Sprachmodell. Das Modell soll die bereitgestellten Informationen verwenden, um eine passende Antwort zu formulieren.
Damit verbinden wir erstmals Retrieval und Generation zu einem vollständigen, wenn auch noch sehr einfachen RAG-System.
Experiment 1.06: Unser erstes vollständiges RAG-System
Wir verwenden wieder unsere kleine Wissensbasis über die fiktive Softwareplattform Orbit.
Unsere Frage lautet:
Experiment ausführen:
Unser Programm führt drei Schritte aus:
- Es erzeugt ein Embedding der Benutzerfrage.
- Es sucht die ähnlichsten Texte in unserer Wissensbasis.
- Es übergibt die gefundenen Informationen als Kontext an ein Sprachmodell, das daraus eine Antwort formuliert.
Retrieval: Den passenden Kontext finden
Zunächst erzeugen wir ein Embedding für die Benutzerfrage und vergleichen es mit den Embeddings unserer Wissensbasis.
Wie im vorherigen Experiment sortieren wir die Ergebnisse anhand ihrer Kosinus-Ähnlichkeit.
Diesmal wählen wir die beiden besten Treffer aus:
Aus den gefundenen Texten erstellen wir anschließend einen gemeinsamen Kontext:
Dieser Kontext enthält die Informationen, die wir dem Sprachmodell zur Verfügung stellen wollen.
Wichtig ist: Bis hierhin haben wir ausschließlich Retrieval durchgeführt. Das Sprachmodell hat noch keine Antwort generiert.
Generation: Aus dem Kontext eine Antwort erzeugen
Jetzt kommt der eigentliche RAG-Schritt.
Wir übergeben dem Sprachmodell sowohl die Benutzerfrage als auch den zuvor zusammengestellten Kontext:
response = client.responses.create(
    model="gpt-4.1-mini",
    instructions=(
        "Answer the question using only the provided context. "
        "If the context does not contain the answer, say that "
        "you do not know."
    ),
    input=(
        f"Context:\n{context}\n\n"
        f"Question:\n{question}"
    ),
)

answer = response.output_text
Die Anweisung fordert das Modell auf, ausschließlich die bereitgestellten Informationen zu verwenden. Falls der Kontext keine Antwort enthält, soll es dies ausdrücklich sagen.
Diese Anweisung verbessert die Steuerung der Antwortgenerierung. Sie garantiert allerdings nicht, dass das Modell sie in jedem Fall korrekt befolgt.
Mit response.output_text lesen wir den vom Sprachmodell generierten Antworttext aus.
Das Ergebnis unseres ersten RAG-Systems
Unser Experiment findet zwei Texte aus der Wissensbasis. Der erste enthält die gesuchte Information über die Wiederholungsdauer fehlgeschlagener Webhooks. Der zweite behandelt die Gültigkeitsdauer von Zugriffstoken und ist für unsere Frage nicht relevant.
Der entscheidende Teil der Konsolenausgabe sieht so aus:
Context:
Orbit retries failed webhook deliveries for 72 hours.
Orbit access tokens are valid for 60 minutes.

Answer:
Orbit retries a failed webhook delivery for 72 hours.
Betrachten wir den Unterschied zwischen Context und Answer genauer.
Der Kontext stammt aus unserer Wissensbasis. Das Retrieval-System hat diese beiden Sätze gefunden und dem Sprachmodell als zusätzliche Informationen übergeben.
Die Antwort unter Answer: wurde dagegen vom Sprachmodell selbst generiert.
Das Modell hat die relevante Information aus dem Kontext übernommen und daraus einen Antwortsatz formuliert:
Gefundene Information:
Orbit retries failed webhook deliveries for 72 hours.
Vom LLM generierte Antwort:
Orbit retries a failed webhook delivery for 72 hours.
Beide Sätze sind fast identisch. Das kann leicht den Eindruck erwecken, unser Programm hätte lediglich den passenden Dokumenttext ausgegeben.
Tatsächlich handelt es sich aber um zwei unterschiedliche Verarbeitungsschritte.
Das Retrieval-System hat den ursprünglichen Satz gefunden. Das Sprachmodell hat anschließend die Benutzerfrage und den bereitgestellten Kontext verarbeitet und daraus seine Antwort erzeugt.
In diesem einfachen Beispiel ist kaum eine Umformulierung notwendig, weil die gesuchte Information bereits vollständig im Kontext steht.
Bei komplexeren Fragen könnte das Sprachmodell mehrere Informationen zusammenführen, längere Dokumentabschnitte zusammenfassen oder eine Antwort verständlicher formulieren.
Dabei bleibt allerdings eine wichtige Einschränkung: Eine generierte Antwort ist nicht automatisch korrekt oder vollständig durch den Kontext belegt. Das müssen wir später gesondert überprüfen.
Was haben wir erreicht?
Wir haben nun alle grundlegenden Schritte einer RAG-Pipeline miteinander verbunden:
flowchart LR
    Q["Benutzerfrage"]
    E["Frage-Embedding erzeugen"]
    R["Ähnliche Texte finden"]
    K["Kontext zusammenstellen"]
    L["LLM: Antwort generieren"]

    Q --> E --> R --> K --> L

    classDef io fill:#dbeafe,stroke:#2563eb,color:#1e3a8a
    classDef retrieval fill:#fef3c7,stroke:#d97706,color:#78350f
    classDef processing fill:#dcfce7,stroke:#16a34a,color:#14532d

    class Q io
    class R retrieval
    class E,K,L processing
Unser System kann eine Frage entgegennehmen, passende Informationen suchen und diese einem Sprachmodell zur Beantwortung bereitstellen.
Damit haben wir unser erstes funktionierendes RAG-System entwickelt.
Fazit: Retrieval und Generation übernehmen unterschiedliche Aufgaben. Das Retrieval-System findet relevante Informationen. Das Sprachmodell verarbeitet diese Informationen gemeinsam mit der Benutzerfrage und generiert daraus eine Antwort.
Unser Experiment funktioniert. Allerdings haben wir bisher mit wenigen, sorgfältig formulierten Beispielsätzen gearbeitet. In realen Anwendungen liegen Informationen meist in umfangreichen Dokumenten vor, und nicht jeder gefundene Text ist tatsächlich relevant.
Warum unser erstes RAG-System deshalb noch weit von einer produktiven Anwendung entfernt ist, betrachten wir im nächsten Abschnitt.
1.8 Unser erstes RAG funktioniert und ist trotzdem unrealistisch
Wir haben unser erstes vollständiges RAG-System entwickelt. Es kann eine Benutzerfrage entgegennehmen, passende Informationen aus einer Wissensbasis suchen und daraus mithilfe eines Sprachmodells eine Antwort generieren.
Unsere Frage nach der Wiederholungsdauer fehlgeschlagener Webhooks wurde korrekt beantwortet. Das System hat den passenden Text gefunden, ihn als Kontext bereitgestellt und eine Antwort mit der gesuchten Information erzeugt.
Das ist ein wichtiger Schritt. Allerdings haben wir uns die Aufgabe bisher ausgesprochen einfach gemacht.
Unsere Wissensbasis ist ungewöhnlich sauber
Unsere Wissensbasis besteht aus wenigen, sorgfältig formulierten Sätzen. Jeder Satz beschreibt genau eine Eigenschaft unserer fiktiven Softwareplattform Orbit.
Beispielsweise:
Dieser Satz ist bereits eine nahezu perfekte Informationseinheit für Retrieval. Er enthält eine klar abgegrenzte Aussage und lässt sich problemlos als einzelner Text in einen Vektor umwandeln.
Reale Unternehmensdokumente sehen anders aus.
Ein technisches Handbuch kann Hunderte Seiten umfassen. Es enthält Überschriften, Absätze, Tabellen, Codebeispiele und möglicherweise mehrere Versionen derselben Information.
Die gesuchte Antwort steht dabei nicht unbedingt in einem einzelnen Satz. Manchmal verteilt sie sich über mehrere Abschnitte oder ergibt sich erst aus dem Zusammenhang.
Wir können deshalb nicht einfach davon ausgehen, dass jedes Dokument bereits eine geeignete Einheit für unsere semantische Suche darstellt.
Bevor wir Informationen sinnvoll suchen können, müssen wir sie zunächst aus den Dokumenten gewinnen und aufbereiten.
Nicht jeder gefundene Text ist relevant
Eine zweite Schwäche haben wir bereits in unseren Experimenten beobachtet.
Bei der Frage nach fehlgeschlagenen Webhooks hat unser Retrieval-System neben dem passenden Webhook-Text auch Informationen über API-Limits oder Zugriffstoken gefunden.
Der Grund ist einfach: Wir haben die ähnlichsten Texte ausgewählt, ohne zu überprüfen, ob sie tatsächlich zur Beantwortung der Frage beitragen.
Unser bisheriges Verfahren kennt nur zwei Schritte:
- Ähnlichkeit berechnen.
- Die besten
kTreffer auswählen.
Es kann nicht zuverlässig beurteilen, ob ein Treffer die gesuchte Information enthält.
Bei fünf kurzen Beispielsätzen fällt das kaum ins Gewicht. In einer großen Dokumentensammlung können jedoch zahlreiche Texte ähnliche Begriffe verwenden, ohne dieselbe Frage zu beantworten.
Außerdem hängt die Qualität des Retrievals davon ab, welche Texte wir überhaupt als durchsuchbare Einheiten bereitstellen.
Wenn ein Dokument zu viel unterschiedlichen Inhalt enthält, kann sein Embedding wichtige Details nur unzureichend repräsentieren. Zerlegen wir den Text dagegen ungeschickt, verlieren wir möglicherweise den Zusammenhang, der für die richtige Antwort erforderlich ist.
Eine plausible Antwort ist noch keine verlässliche Antwort
Unser Sprachmodell hat die Webhook-Frage korrekt beantwortet. Das bedeutet allerdings nicht, dass unser RAG-System bereits zuverlässig arbeitet.
Wir haben bisher nur einen einfachen Fall betrachtet, in dem die richtige Information ausdrücklich im Kontext enthalten war.
Was passiert, wenn der Kontext unvollständig ist? Wenn zwei Dokumente unterschiedliche Angaben enthalten? Oder wenn die Wissensbasis überhaupt keine Antwort auf die Frage liefert?
Ein Sprachmodell kann auch unter solchen Bedingungen eine überzeugend klingende Antwort formulieren. Ob diese Antwort sachlich korrekt ist und tatsächlich durch die bereitgestellten Informationen gestützt wird, ist eine andere Frage.
Unsere Anweisung, ausschließlich den Kontext zu verwenden, reduziert dieses Risiko möglicherweise, ersetzt aber keine systematische Qualitätskontrolle.
Wir werden deshalb später nicht nur untersuchen müssen, welche Dokumente unser Retrieval findet, sondern auch, wie zuverlässig das Sprachmodell die gefundenen Informationen verwendet.
Was unserem System noch fehlt
Unser erstes RAG demonstriert die grundlegende Architektur. Für den Einsatz mit realen Dokumenten fehlen jedoch mehrere Fähigkeiten:
| Bereich | Bisheriger Stand | Was noch fehlt |
|---|---|---|
| Dokumente | Wenige manuell formulierte Sätze | Unterschiedliche Dateiformate laden und verarbeiten |
| Textaufbereitung | Jeder Satz ist bereits eine Informationseinheit | Längere Dokumente sinnvoll zerlegen |
| Retrieval | Kosinus-Ähnlichkeit und Top-k | Trefferqualität verbessern und ungeeignete Ergebnisse erkennen |
| Wissensbasis | Kleine Liste im Python-Code | Größere Dokumentbestände speichern und durchsuchen |
| Antwortqualität | Einzelne erfolgreiche Beispielantwort | Korrektheit und Quellenbindung systematisch überprüfen |
Diese Einschränkungen bedeuten nicht, dass unser bisheriger Ansatz falsch ist. Im Gegenteil: Wir haben die wesentlichen Bausteine kennengelernt, auf denen auch umfangreichere RAG-Systeme aufbauen.
Der entscheidende Unterschied liegt darin, wie wir die Wissensbasis vorbereiten, durchsuchen und die Ergebnisse bewerten.
Damit sind wir an dem Punkt angekommen, an dem aus unserem kleinen Python-Experiment eine realistischere RAG-Anwendung werden kann.
1.9 Was wir gelernt haben – und was noch fehlt
In diesem Kapitel haben wir die grundlegende Funktionsweise von Retrieval-Augmented Generation Schritt für Schritt untersucht.
Wir haben nicht mit einem fertigen RAG-Framework begonnen, sondern die einzelnen Bausteine selbst in Python nachvollzogen. Dadurch konnten wir beobachten, wie aus einem Text zunächst eine numerische Repräsentation wird, wie wir damit Informationen suchen und wie ein Sprachmodell aus den gefundenen Informationen eine Antwort erzeugt.
Unsere sechs Experimente im Überblick
| Experiment | Zentrale Erkenntnis |
|---|---|
| 1.01 Tokenisierung | Ein Tokenizer zerlegt Text in Token und ordnet ihnen numerische IDs zu. |
| 1.02 Erstes Embedding | Ein Embedding-Modell verarbeitet Text und erzeugt daraus einen Vektor, der den gesamten Text repräsentiert. |
| 1.03 Mehrere Embeddings | Mit demselben Modell erzeugte Text-Embeddings liegen in einem gemeinsamen Vektorraum und können miteinander verglichen werden. |
| 1.04 Kosinus-Ähnlichkeit | Wir können die Ähnlichkeit zwischen einer Benutzerfrage und vorhandenen Texten mathematisch bestimmen. |
| 1.05 Retrieval | Durch Sortierung der Ähnlichkeitswerte und Top-k-Auswahl finden wir die wahrscheinlich relevantesten Texte. |
| 1.06 Erstes RAG-System | Ein Sprachmodell kann die gefundenen Texte als Kontext verwenden und daraus eine Antwort generieren. |
Was wir noch nicht gelöst haben
Unser erstes RAG-System funktioniert, weil wir ihm bereits gut vorbereitete Informationen zur Verfügung stellen.
In einer realen Anwendung beginnt die Arbeit jedoch früher.
Dort liegen Informationen beispielsweise in Markdown-Dateien, PDFs, HTML-Seiten oder Word-Dokumenten vor. Diese Dokumente müssen zunächst eingelesen und in eine geeignete Textdarstellung überführt werden.
Anschließend stellt sich eine entscheidende Frage:
Wie zerlegen wir ein langes Dokument in Abschnitte, die groß genug sind, um ihren Zusammenhang zu bewahren, und gleichzeitig klein genug, um gezielt gefunden zu werden?
Diese Textabschnitte werden als Chunks bezeichnet.
Ihre Größe, ihre Grenzen und die Informationen, die wir zusätzlich über sie speichern, beeinflussen unmittelbar die Qualität des späteren Retrievals.
Damit wird deutlich, warum wir uns nicht allein auf die Wahl eines guten Embedding-Modells verlassen können. Bereits die Vorbereitung unserer Dokumente entscheidet darüber, welche Informationen unser RAG-System später überhaupt finden kann.
Ausblick auf Kapitel 2
Im nächsten Kapitel verlassen wir unsere kleine Sammlung manuell formulierter Beispielsätze.
Stattdessen arbeiten wir mit einem umfangreicheren Dokumentencorpus unseres fiktiven Unternehmens Teralune. Er enthält unterschiedliche Dokumenttypen und realistischere Strukturen, wie sie auch in technischen Wissensbeständen vorkommen.
Wir werden lernen, Dokumente einzulesen, ihre Inhalte zu extrahieren und sie mit verschiedenen Chunking-Verfahren in durchsuchbare Einheiten zu zerlegen.
Dabei untersuchen wir auch, welche Informationen über Herkunft und Struktur eines Textabschnitts erhalten bleiben sollten.
Unser nächstes Ziel ist deshalb nicht, ein neues Sprachmodell einzusetzen. Wir wollen die Wissensbasis so vorbereiten, dass unser bestehendes Retrieval überhaupt sinnvoll mit realen Dokumenten arbeiten kann.